LLM 이 모르는 회사 문서를 파인튜닝 없이 답하게 만드는 RAG 의 구조 — 청킹·임베딩·벡터 DB·검색·Reranking — 를 색인과 질의 두 흐름으로 정리했습니다.
LLM 에게 사내 규정을 물어보면 모른다고 하거나 그럴듯하게 지어냅니다. 학습이 끝난 뒤의 일도, 회사 안의 문서도 모르기 때문입니다. 파인튜닝으로 넣기엔 문서가 너무 자주 바뀌는데 그럼 뭐가 답일까요? 저도 처음엔 "문서를 통째로 프롬프트에 넣으면 되지 않나" 싶었습니다. 그게 모델의 컨텍스트 한계에 걸린다는 걸 알고 나서야 RAG 가 왜 이렇게 생겼는지 이해가 됐습니다. 필요한 조각만 찾아서 프롬프트에 붙인다 — 그게 RAG 이고 색인과 질의 두 흐름으로 되어 있습니다.
모델이 회사 문서를 모르는 이유
모델의 파라미터는 학습으로 정해진 뒤 고정됩니다. 그 학습 데이터는 공개 웹 텍스트이고 특정 시점에서 끊깁니다. 우리 회사의 사내 규정, 지난달 회의록, 고객 계약서는 애초에 거기 없습니다.
파인튜닝으로 넣을 수도 있지만 문서가 바뀔 때마다 재학습해야 하고 출처를 보여 줄 수 없습니다. 2020년 Meta(당시 Facebook AI Research)의 Patrick Lewis 등이 낸 논문이 다른 길을 제안했습니다. 필요한 문서를 검색해서 프롬프트에 넣어 주자. Retrieval-Augmented Generation, 줄여서 RAG 입니다.
먼저 문서를 벡터로 바꿔 둡니다 — 색인
RAG 는 두 흐름으로 나뉩니다. 문서를 미리 준비해 두는 색인과 질문이 올 때 도는 질의입니다. 색인부터 보겠습니다.
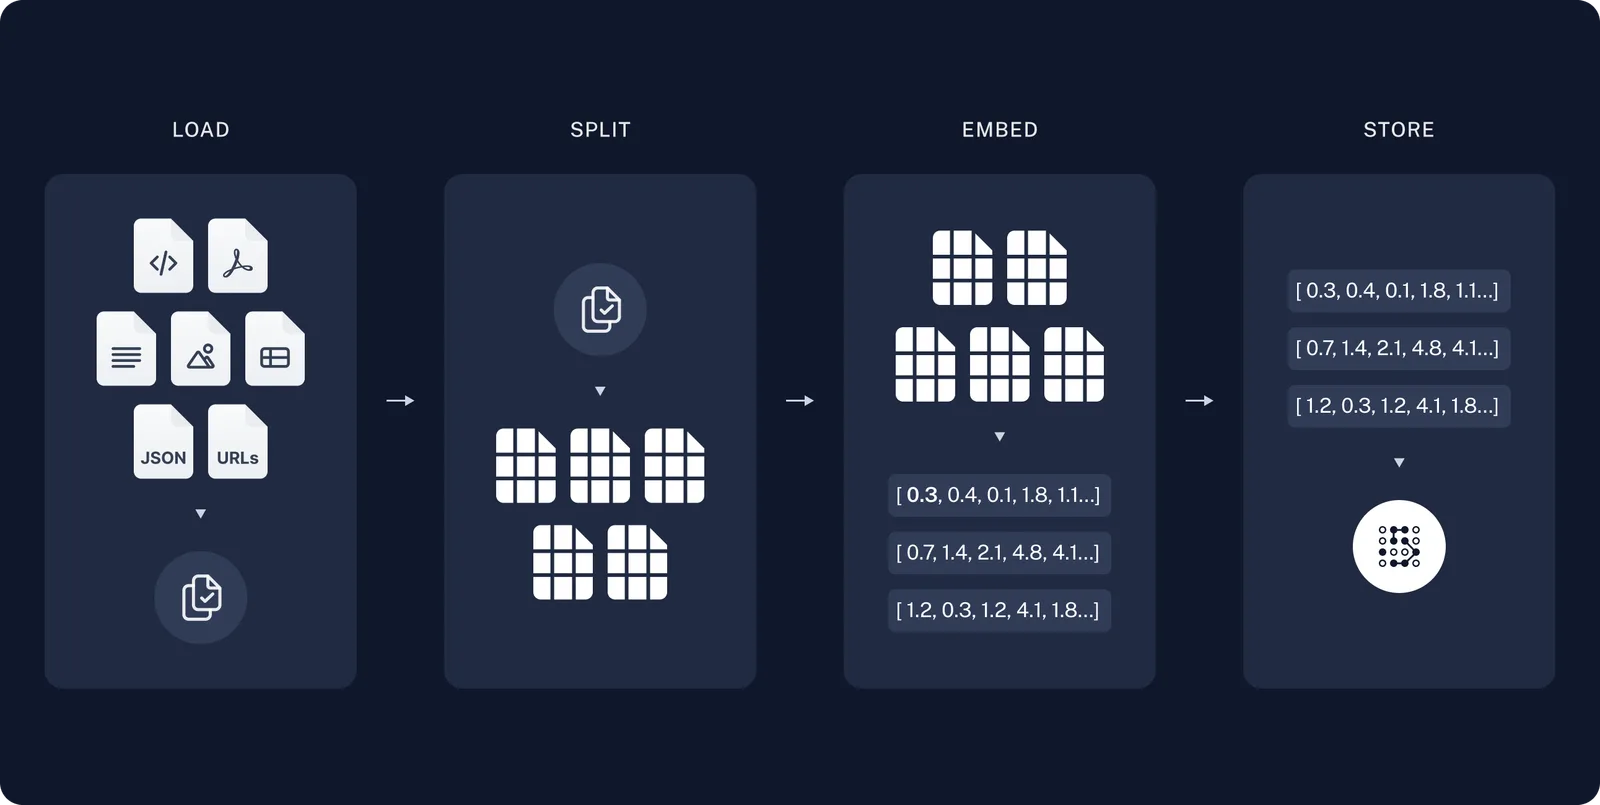
Load 는 PDF·워드·위키·DB 에서 텍스트를 뽑는 단계입니다. Split 은 그 텍스트를 조각으로 자르는 Chunking 입니다. 왜 자를까요? 문서 한 통을 통째로 넣으면 모델의 컨텍스트가 넘치고 검색도 둔해지기 때문입니다. 그래서 수백 토큰 단위로 자르고 문단 경계를 살리고 조각 사이를 조금 겹치게 둡니다. 어디서 자르느냐가 답변 품질에 생각보다 크게 영향을 줍니다.
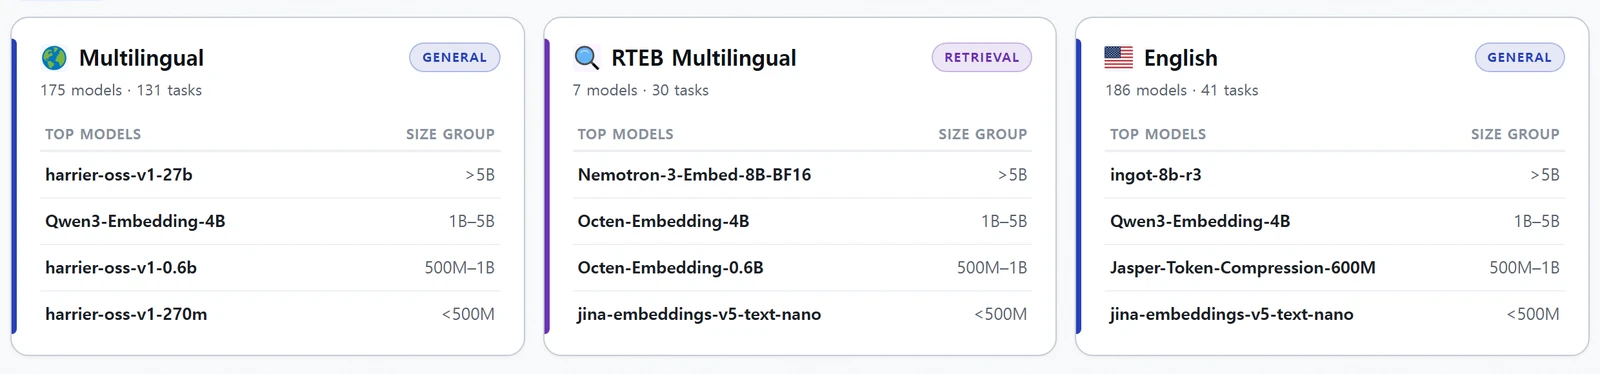
Embed 는 문서 조각을 숫자 벡터로 바꾸는 단계입니다. 조각마다 임베딩 모델을 통과시켜 숫자 벡터 하나를 얻습니다. 뜻이 비슷한 조각은 벡터도 가깝습니다. 이 임베딩 모델은 답을 만드는 LLM 과 별개의 작은 모델이고 어떤 것을 고를지는 MTEB 같은 벤치마크를 참고합니다.
Store 는 그 벡터를 원문 조각·출처와 함께 벡터 DB 에 넣는 단계입니다.
가까운 벡터를 빨리 찾는 저장소 — 벡터 DB
벡터 DB 가 하는 일은 하나입니다. 벡터 하나를 주면 가장 가까운 벡터 k 개를 돌려주는 것입니다. 이 검색을 유사도 검색(Similarity Search)이라고 하고 거리 기준으로는 두 벡터가 이루는 각도로 재는 코사인 유사도를 가장 많이 씁니다. 같은 방향이면 1, 무관하면 0 에 가깝습니다.
조각이 수백만 개면 전부 비교할 수 없으니 HNSW 같은 근사 색인으로 후보를 줄입니다. 정확도를 조금 내주고 속도를 얻는 구조라 양자화와 같은 종류의 거래입니다. 제품으로는 Postgres 확장인 pgvector, 전용 DB 인 Milvus·Qdrant·Weaviate, 가볍게 쓰는 Chroma 가 있습니다. 이미 Postgres 를 쓰고 있다면 pgvector 로 시작하는 게 운영 부담이 가장 적습니다.
파라미터와 벡터 DB 가 왜 다른 것인지가 여기서 분명해집니다. 벡터 DB 의 내용은 문서를 넣고 빼면 바로 바뀌고 모델은 그대로입니다.
질문이 오면 — 검색해서 붙이고 답하기
질문이 오면 색인과 반대 순서로 갑니다.
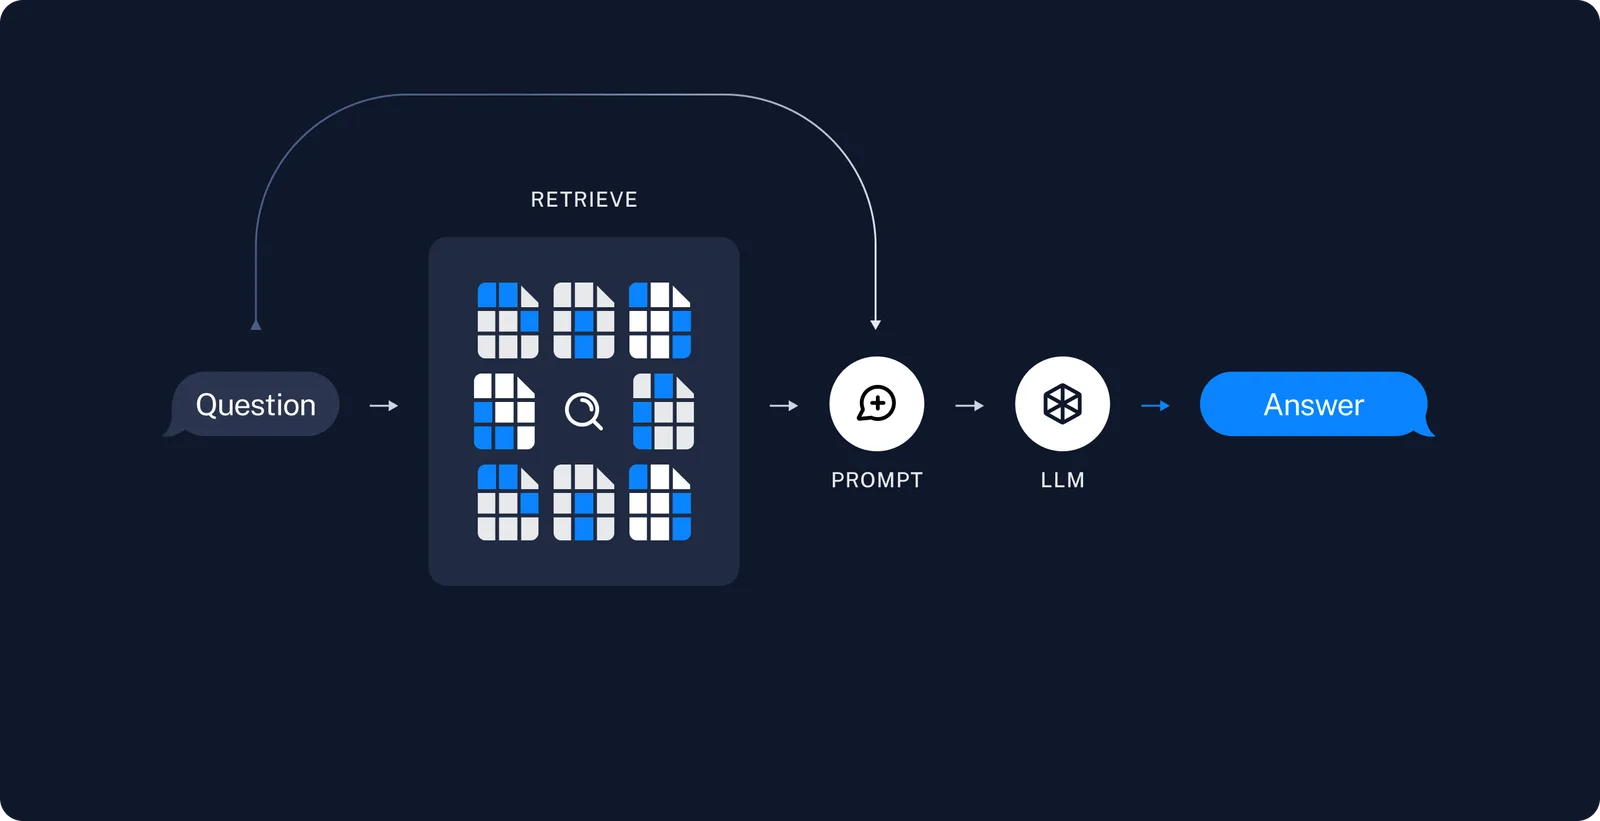
질문을 같은 임베딩 모델로 벡터로 바꿉니다. 벡터 DB 에서 가까운 조각 k 개를 찾습니다(Retrieval). 찾은 조각의 원문을 프롬프트에 붙입니다(Prompt Augmentation). "아래 문서를 근거로 답하라"는 지시와 함께 LLM 에 보내고 답을 받습니다(Generation).
프롬프트가 실제로 이렇게 생깁니다.
다음 문서를 근거로 질문에 답하세요. 문서에 없는 내용은 모른다고 하세요.

[문서 1] 연차는 입사 1년 미만 직원의 경우 1개월 개근 시 1일씩 발생한다. (출처: 취업규칙 §12)
[문서 2] 연차 사용 촉진 절차는 … (출처: 인사팀 공지 2026-03)

질문: 입사 6개월 차인데 연차가 며칠인가요?
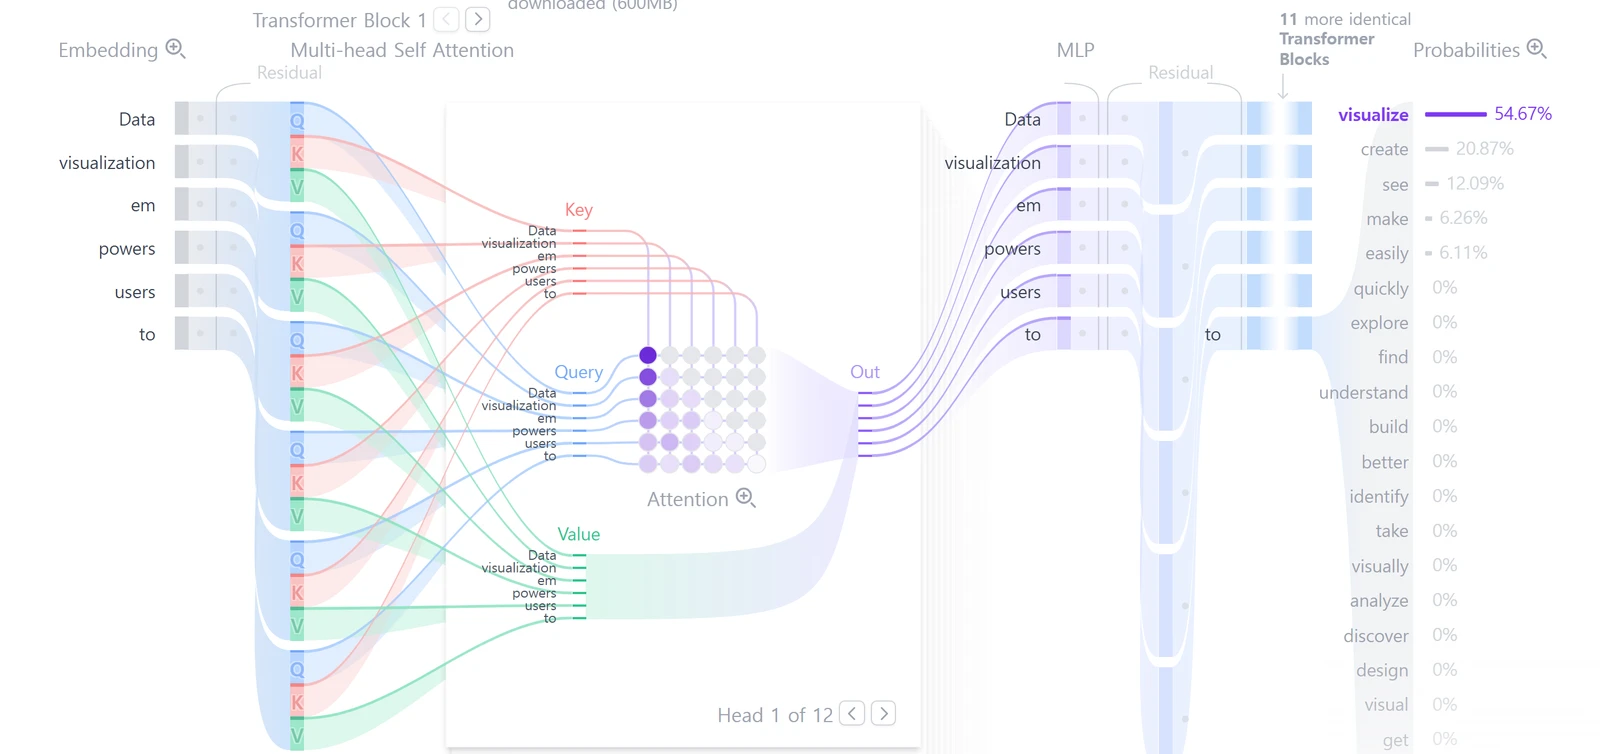
LLM 이 하는 일은 평소와 같습니다. 프롬프트를 읽고 다음 토큰을 고를 뿐입니다. 다만 그 프롬프트 안에 답의 근거가 들어 있으니 지어낼 이유가 줄고 어느 문서에서 왔는지도 같이 말할 수 있습니다.
찾은 것 중에서 다시 고릅니다 — Reranking
그런데 벡터 검색은 빠른 대신 거칩니다. 상위 20개를 가져오면 그중 정말 관련 있는 건 보통 서너 개입니다. 그래서 검색 뒤에 Reranker 를 한 단계 더 둡니다. 질문과 조각을 한 쌍으로 같이 읽고 관련도 점수를 매기는 모델입니다. 임베딩처럼 따로따로 벡터를 만들지 않고 둘을 붙여 읽으니 정확하고 그만큼 느립니다. 그래서 전체가 아니라 벡터 검색이 추린 후보에만 씁니다.
벡터 검색 20개 → Reranker 로 3~5개 → 프롬프트. 이 두 단계 구조가 실무 RAG 의 기본 형태입니다.
파인튜닝과 다시 견주면
파인튜닝과 견주면 RAG 는 모델이 무엇을 보고 답할지를 바꿉니다. 문서가 바뀌면 색인만 다시 하면 되고 답마다 출처를 붙일 수 있고 GPU 학습이 필요 없습니다. 대신 임베딩 모델·벡터 DB·Reranker 라는 부품이 세 개 늘고 검색이 틀리면 답도 틀립니다. 그래서 RAG 의 품질은 LLM 보다 검색 품질에서 갈리는 경우가 대부분입니다.
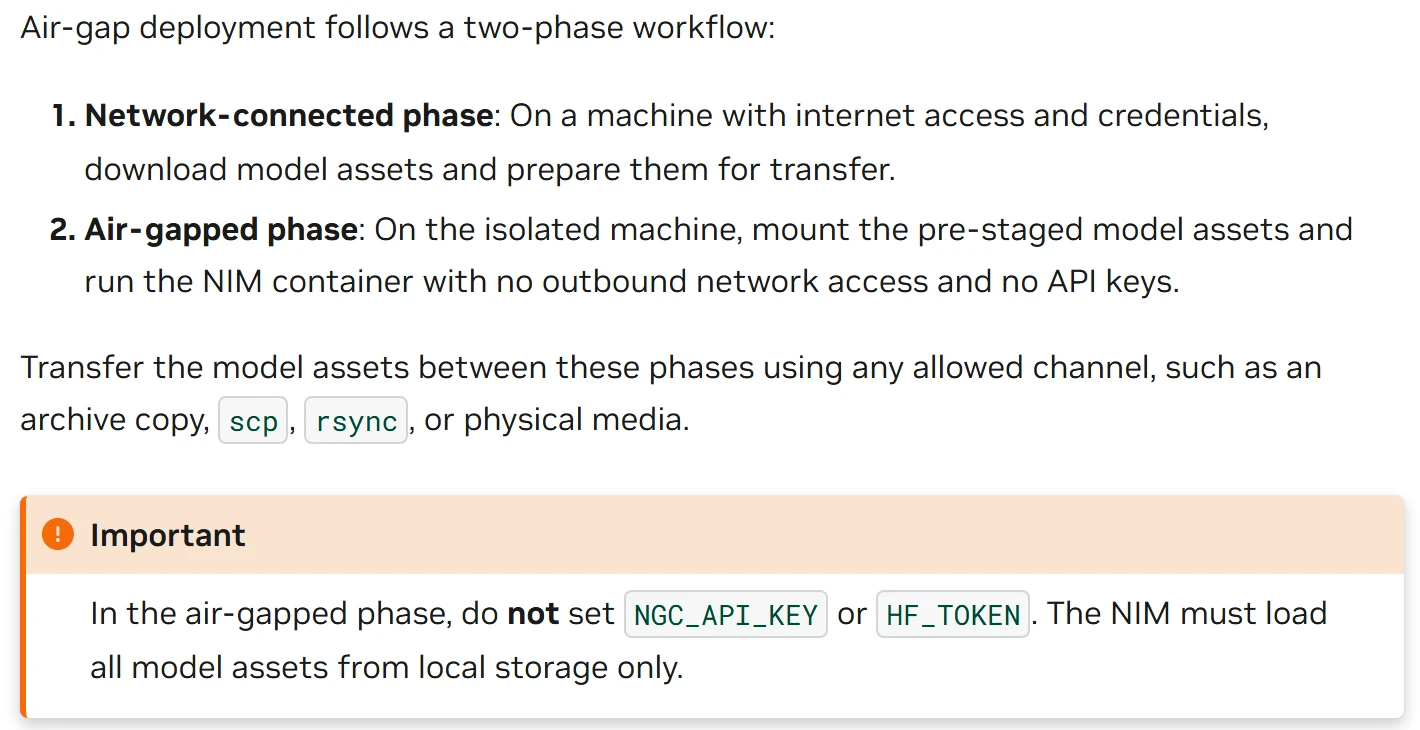
그럼 이 구조를 인터넷이 끊긴 회사 안에서 돌리려면 어떻게 해야 할까요? 임베딩 모델도 벡터 DB 도 LLM 도 전부 안에 있어야 합니다. 다음 글에서 폐쇄망 RAG 에 대해서 알아보겠습니다.