배포한 모델이 시간이 지나며 나빠지는 이유(Data Drift)와 그걸 재는 지표(Precision·Recall), 계속 돌리는 비용(TCO), 안에 뭐가 들었는지 아는 일(SBOM·SAST)까지 배포 이후의 운영을 정리했습니다.
모델을 만들고 서버에 올리기까지가 AI 프로젝트의 전부처럼 보입니다. 그런데 저는 실제로 서비스에 올린 모델이 반년쯤 지나 이상한 답을 내기 시작하는 걸 보고 나서야 "배포는 시작이구나"를 실감했습니다. 코드는 한 줄도 안 바뀌었는데 왜 나빠질까요? 들어오는 데이터가 학습 때와 달라졌기 때문입니다. 이걸 Data Drift 라고 부르는데 운영이 왜 큰일인지부터 보고 나서 이 이야기로 들어가겠습니다.
모델 코드는 전체의 작은 상자일 뿐입니다
먼저 운영이 왜 큰일인지부터 보겠습니다. Google 의 MLOps 문서가 2015년 논문 "Hidden Technical Debt in Machine Learning Systems" 의 그림을 가져와 이렇게 보여 줍니다.
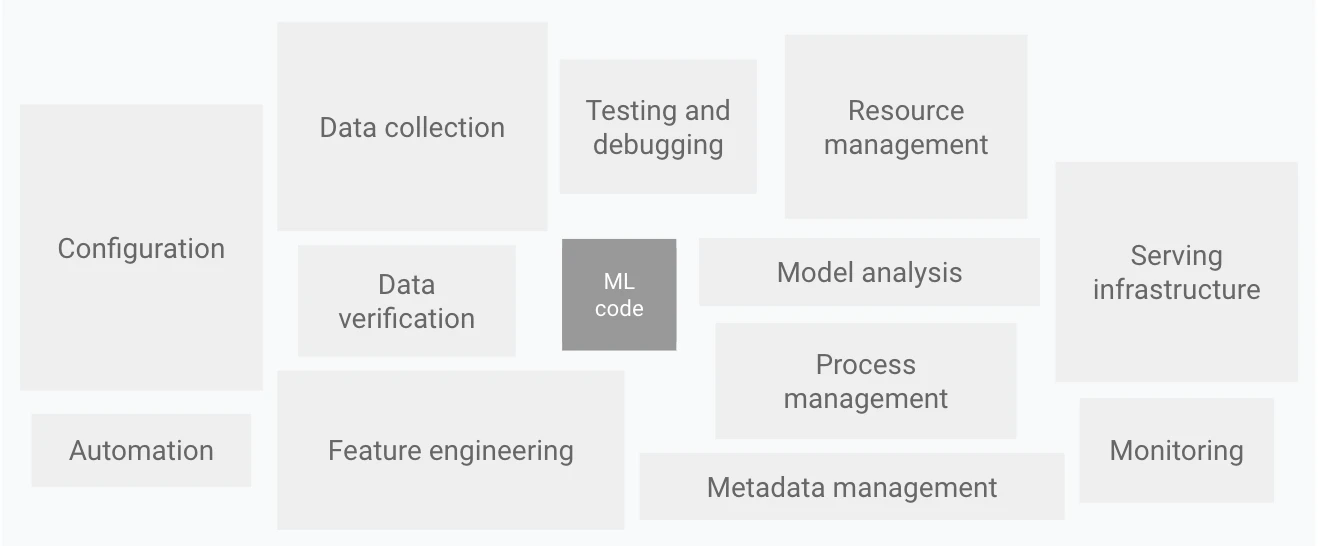
가운데 작고 진한 상자가 ML 코드입니다. 나머지 — 데이터 수집·검증, 피처 엔지니어링, 서빙 인프라, 모니터링, 메타데이터 관리 — 가 실제 시스템의 대부분입니다. GPU·서빙·데이터 플랫폼 같은 인프라 이야기도 대부분 그 바깥 상자들입니다. 이 바깥을 자동화하고 반복 가능하게 만드는 일을 MLOps 라고 부릅니다. 소프트웨어의 DevOps 에 "데이터와 모델도 버전이 있고 바뀐다"는 조건이 붙은 것입니다.
모델을 나빠지게 하는 Data Drift
서두의 질문입니다. 코드는 그대로인데 왜 나빠질까요? 고객 이탈 예측 모델을 2025년 데이터로 학습했다고 하겠습니다. 2026년에 신규 가입 채널이 바뀌어 젊은 고객이 늘면, 모델에 들어오는 나이 열의 분포가 학습 때와 달라집니다. 이것이 Data Drift 입니다. 모델은 그대로인데 입력이 달라져 예측이 어긋납니다.
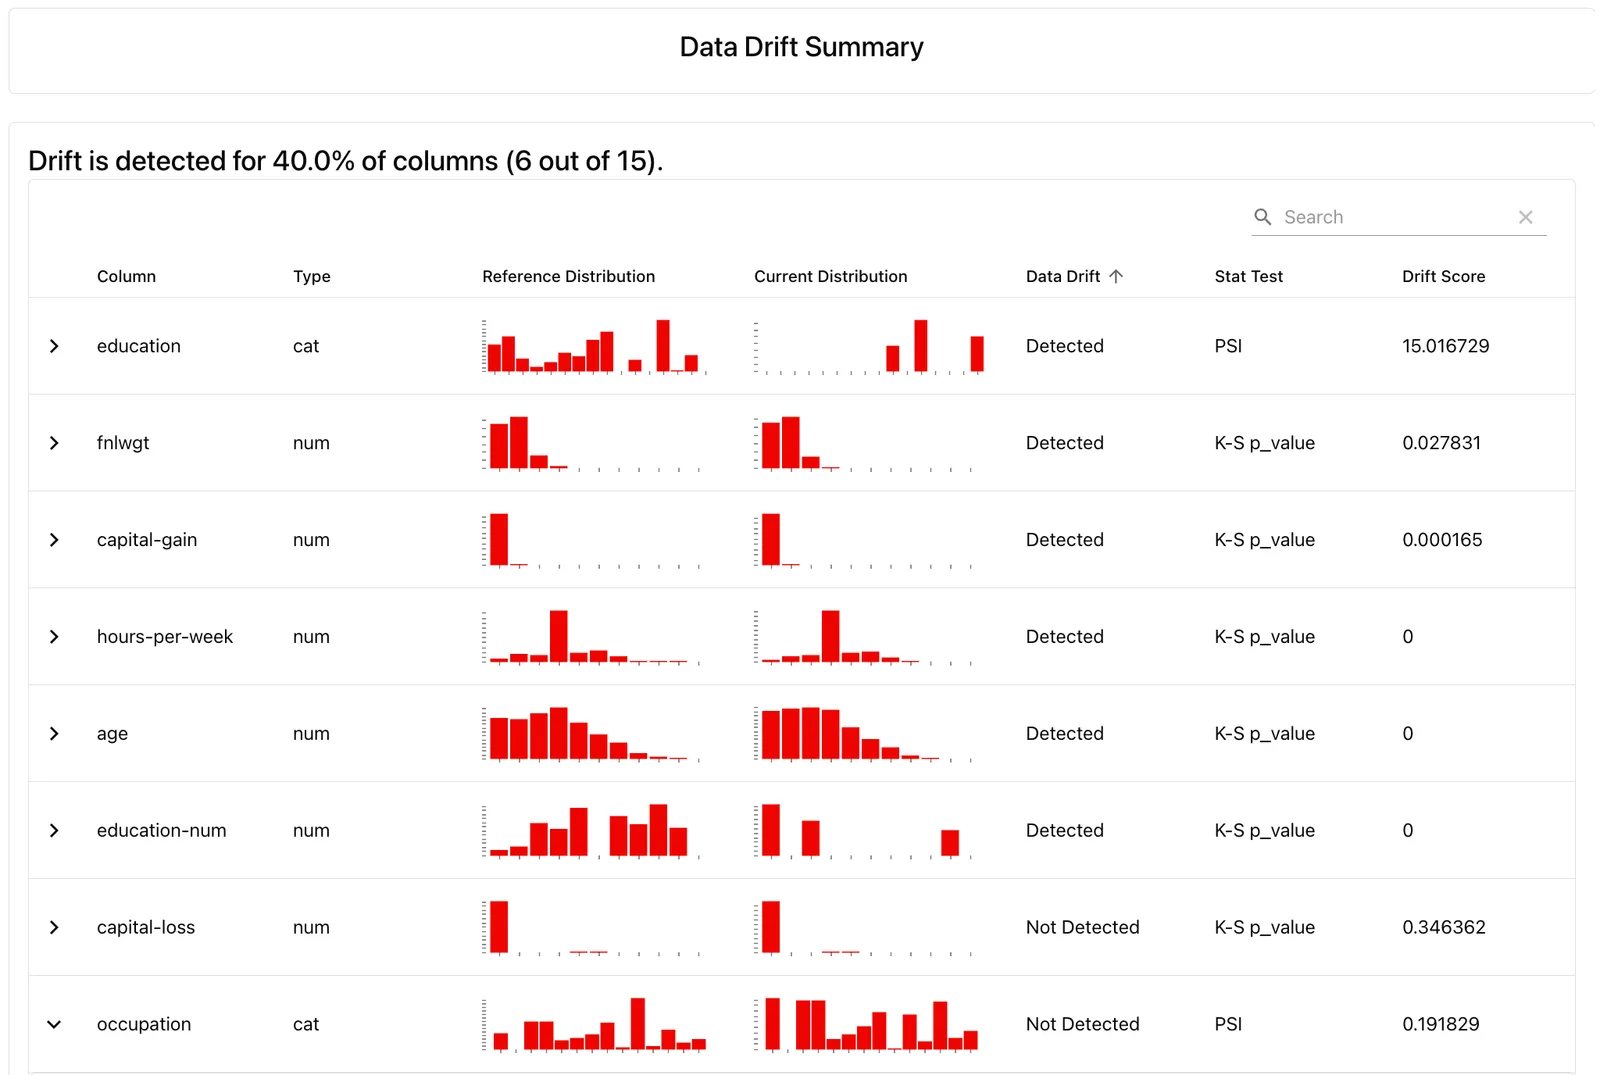
위 화면은 오픈소스 모니터링 도구 Evidently 의 리포트입니다. 열마다 학습 시점 분포와 현재 분포를 나란히 놓고 통계 검정(K-S, PSI)으로 "달라졌다"를 판정합니다. 15개 열 중 6개에서 drift 가 잡혔습니다. 이런 리포트를 데이터 플랫폼에 쌓이는 최신 데이터로 매일 돌리는 것이 Model Monitoring 의 기본입니다.
입력은 그대로인데 입력과 정답의 관계가 바뀌는 경우도 있습니다. 같은 나이·같은 구매 이력인데 이탈률 자체가 바뀌는 식입니다. 이것은 Concept Drift 라고 따로 부릅니다. 정답이 나중에야 확인되는 문제라 Data Drift 보다 늦게 잡힙니다.
둘 중 어느 쪽이든 결론은 같습니다. 정확도가 떨어지면 최신 데이터로 재학습해서 다시 배포합니다. 그래서 MLOps 파이프라인은 학습을 한 번 하고 끝내지 않고 주기적으로 또는 drift 가 잡힐 때 자동으로 다시 도는 구조로 만듭니다.
나빠진 정도를 재는 오탐과 미탐
그럼 "나빠졌다"는 무엇으로 잴까요? "정확도 99%" 는 좋아 보이지만 사기 거래가 전체의 0.5% 라면 전부 정상이라고 답해도 99.5% 입니다. 그래서 분류 모델은 틀린 종류를 나눠 셉니다.
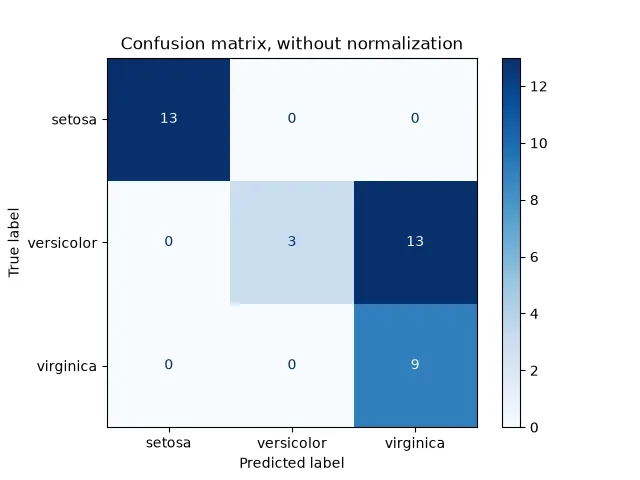
- 오탐(False Positive) — 아닌데 맞다고 함. 정상 거래를 사기로 막음.
- 미탐(False Negative) — 맞는데 아니라고 함. 사기 거래를 통과시킴.
이 둘로 두 지표를 만듭니다. Precision 은 "맞다고 한 것 중 진짜 맞은 비율", 오탐이 많으면 떨어집니다. Recall 은 "진짜 맞는 것 중 잡아낸 비율", 미탐이 많으면 떨어집니다. 둘은 보통 반비례합니다. 문턱을 낮춰 더 많이 잡으면 Recall 은 오르고 Precision 은 내려갑니다.
어느 쪽을 택할지는 업무가 정합니다. 모델이 정하지 않습니다. 암 검진은 미탐이 치명적이니 Recall 을, 스팸 필터는 중요한 메일을 버리는 오탐이 더 아프니 Precision 을 우선합니다. 인프라가 전부 잘 돌아도 이 선택이 틀리면 모델은 쓸모가 없습니다.
계속 돌릴 때의 비용 TCO
TCO(Total Cost of Ownership)는 도입부터 폐기까지의 총비용입니다. AI 시스템에서 눈에 띄는 것은 GPU 이지만 실제 청구서에는 더 많은 항목이 있습니다.
| 클라우드 | 온프레미스 | |
|---|---|---|
| GPU | 시간당 과금, 안 쓰면 0 | 구매 후 감가상각, 안 써도 비용 |
| 전력·냉각·상면 | 요금에 포함 | 별도 (H100 서버 한 대 수 kW) |
| 운영 인력 | 관리형 서비스로 일부 대체 | K8s·GPU 드라이버·서빙 계층을 직접 |
| 데이터 이동 | Egress 요금 | 없음 |
| 유리한 경우 | 부하 변동 큼, 실험 단계 | 24시간 고부하, 폐쇄망 |
경험적으로 GPU 를 하루 종일 꽉 채워 쓰는 워크로드는 2~3년 기준 온프레미스가 싸고 낮에만 쓰거나 실험 단계면 클라우드가 쌉니다. 다만 온프레미스는 표의 셋째 줄, 서빙 계층 전부를 사람이 운영해야 한다는 비용이 GPU 값에 안 보이게 숨어 있습니다.
LLM 쪽은 계산 단위가 하나 더 있습니다. 토큰입니다. 같은 GPU 에서 vLLM 이 초당 몇 토큰을 뽑느냐가 곧 토큰당 원가입니다. 양자화와 KV Cache 라우팅이 그 원가를 낮추는 장치입니다.
안에 뭐가 들어 있는지 적는 SBOM
서빙에 쓰는 컨테이너 이미지 안에는 vLLM 뿐 아니라 PyTorch, CUDA 라이브러리, Python 패키지 수백 개가 들어 있습니다. 그중 하나에 취약점이 공개되면 "우리 이미지에 그게 있나"를 즉시 답해야 합니다. 그 답을 미리 적어 둔 목록이 SBOM(Software Bill of Materials)입니다. 부품 명세서라는 뜻 그대로 패키지 이름·버전·해시·라이선스를 나열합니다.
형식은 CycloneDX 와 SPDX 두 가지가 표준이고 Syft·Trivy 같은 도구가 이미지를 스캔해 자동으로 만듭니다. 2021년 미국 행정명령 이후 공공 조달에서 SBOM 제출이 요구되기 시작했고 국내 공공·금융도 같은 방향입니다. AI 시스템에서는 여기에 모델 파일의 해시와 출처까지 넣어야 합니다. 폐쇄망이라면 반입 단계에서 적어 둔 해시가 여기에 들어갑니다.
SBOM 이 있으면 의존성 취약점 점검이 목록 대조로 끝납니다. 새 CVE 가 뜨면 SBOM 을 검색해 해당 버전이 있는지 보고 있으면 갱신·반입 절차를 다시 돌립니다.
코드를 실행하기 전에 검사하는 SAST
SAST(Static Application Security Testing)는 코드를 실행하지 않고 읽어서 취약한 패턴을 찾는 검사입니다. 하드코딩된 API 키, SQL 주입 가능한 문자열 조합, 안전하지 않은 역직렬화. Semgrep·CodeQL·Bandit 같은 도구가 CI 에서 커밋마다 돕니다.
AI 시스템에 SAST 가 더 필요한 이유가 있습니다. RAG 는 사용자 입력을 프롬프트에 그대로 붙이고 그 프롬프트가 도구를 호출하기도 합니다. 프롬프트 주입으로 검색 범위를 벗어나거나 권한 밖 문서를 읽게 만드는 경로가 코드 안에 있는지, 실행 전에 봐야 합니다. pickle 형식(.bin) 모델 파일을 여는 코드도 SAST 가 잡는 대표 패턴입니다.
시리즈를 덮으며
이 시리즈는 모델 파일 안의 76억 개 숫자에서 시작했습니다. 그 숫자가 문장을 읽고 토큰을 만들고 GPU 에 올라가고 서버가 되고 클러스터가 되고 회사에 맞게 고쳐지고 문서를 찾아 답하고 인터넷 없이 돌고 데이터 플랫폼 위에 서고 LLM 이 아닌 모델들과 나란히 놓이고 이 글에서 운영됩니다.
이 열두 조각이 한 장의 그림으로 이어지면, 새 모델·새 프레임워크가 나올 때 "이건 어느 칸의 이야기인가"를 먼저 물을 수 있습니다. 그 질문이 이 시리즈가 남기고 싶은 습관입니다.