LLM 인프라 입문
파라미터부터 운영까지, LLM에 대한 기초
- 01
LLM 모델 뒤에 붙는 B가 뭘까요?
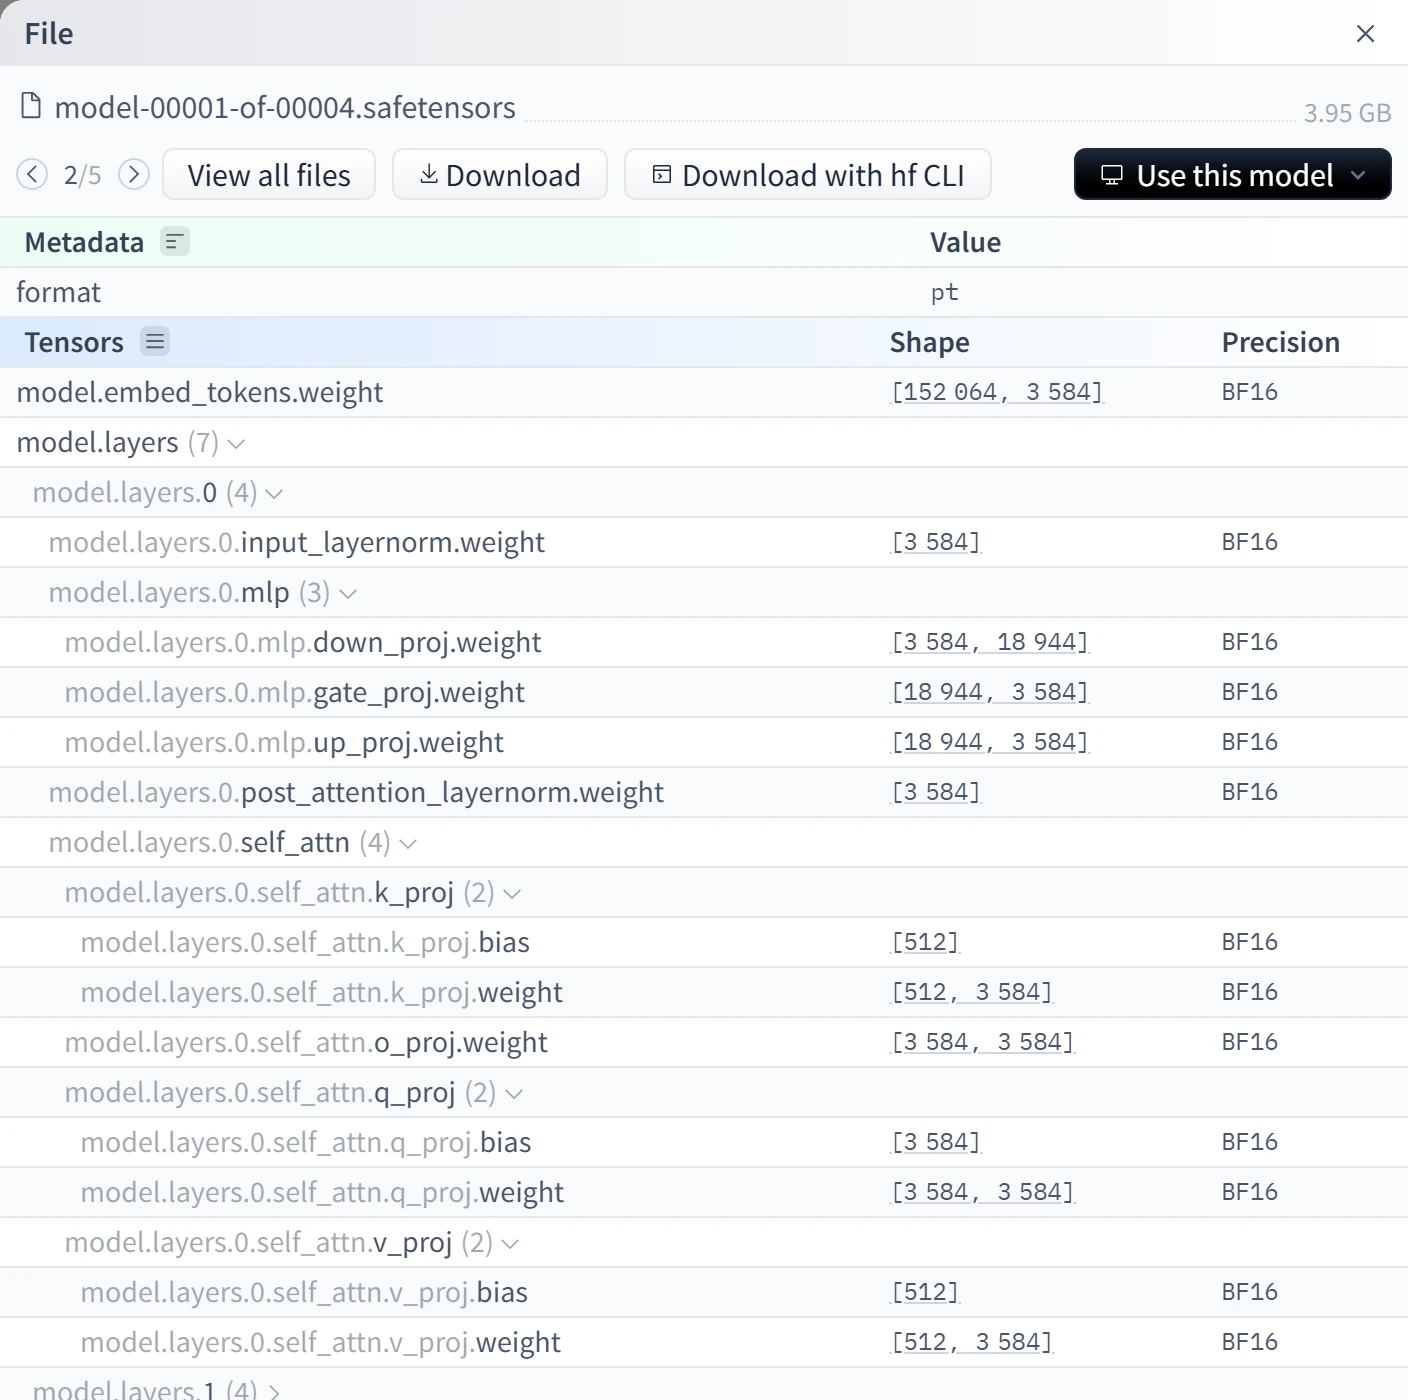
Hugging Face 모델 이름 뒤에 붙는 7B·70B 의 B 는 파라미터 개수입니다. 그 76억 개 숫자가 파일 어디에 어떻게 들어 있는지 실제 모델 파일을 열어 확인하고 학습·추론·벡터 DB 와 어떻게 이어지는지 정리했습니다.
- 02
LLM이 문장을 읽는 순서, 토큰·임베딩·Attention
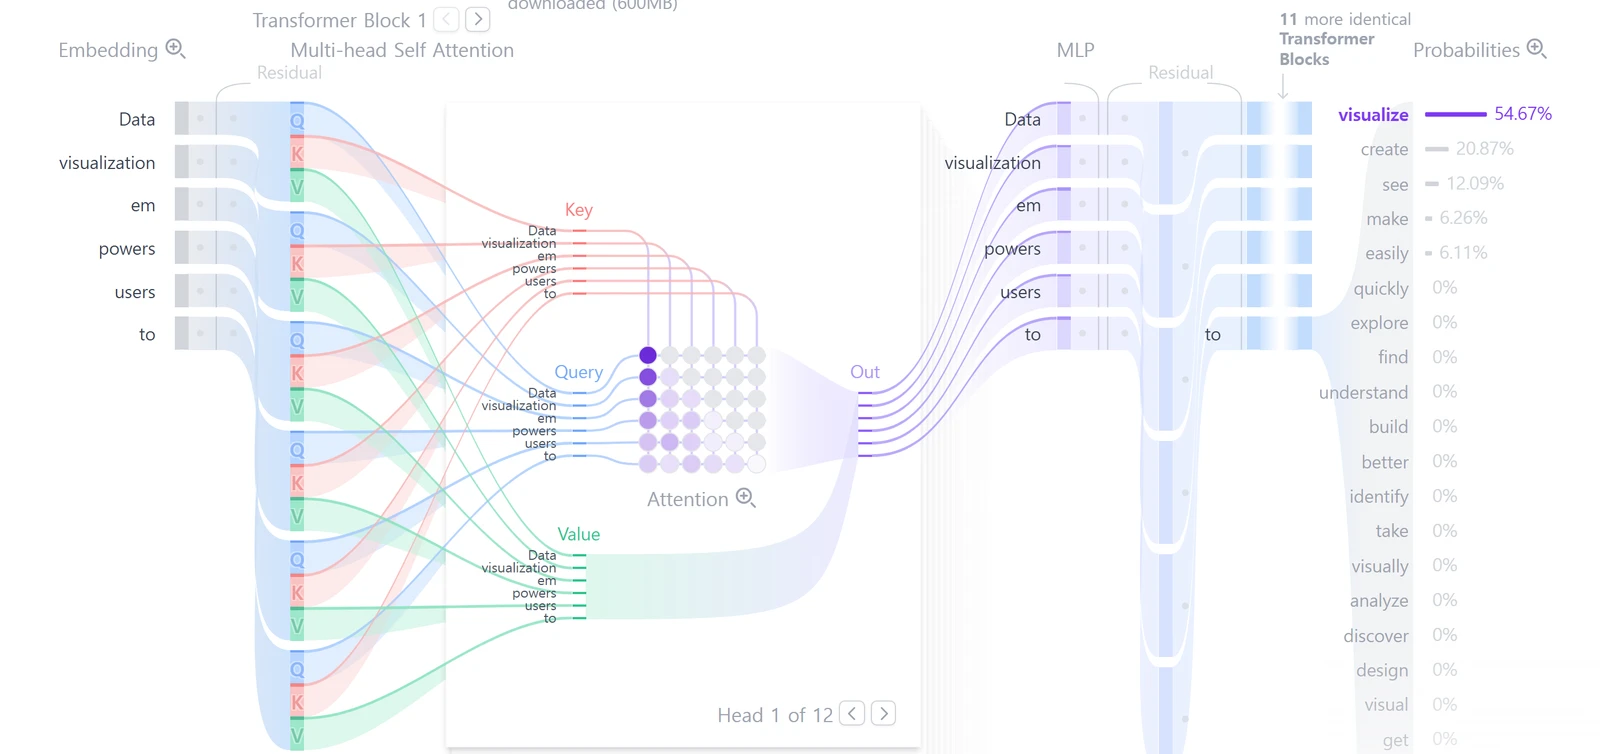
모델 파일 안의 숫자 표가 문장을 읽는 순서 — 토큰으로 자르고 임베딩으로 벡터를 만들고 Attention 으로 관계를 계산해 다음 토큰 하나를 고르기까지 — 를 Transformer Explainer 화면과 함께 따라갑니다.
- 03
LLM 답변은 왜 첫 글자만 늦게 나올까요?
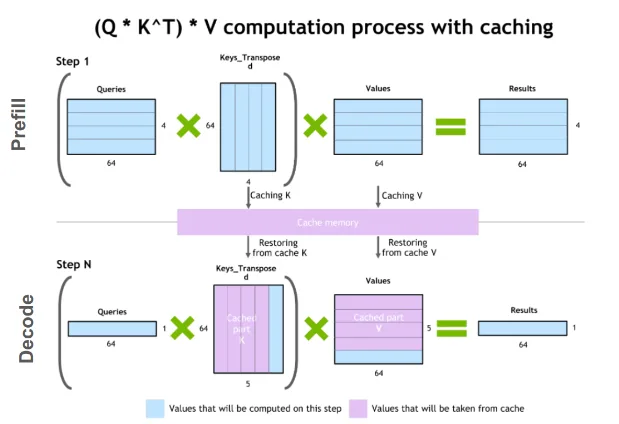
챗봇 답변의 첫 글자만 늦는 이유는 답을 만드는 과정이 Prefill 과 Decode 두 단계로 나뉘고 병목이 서로 다르기 때문입니다. 둘 사이의 KV Cache 가 왜 필요하고 얼마나 큰지, TTFT·Tokens/sec 가 뭘 재는지 정리했습니다.
- 04
7B 모델에 GPU 메모리 14GB가 필요한 이유
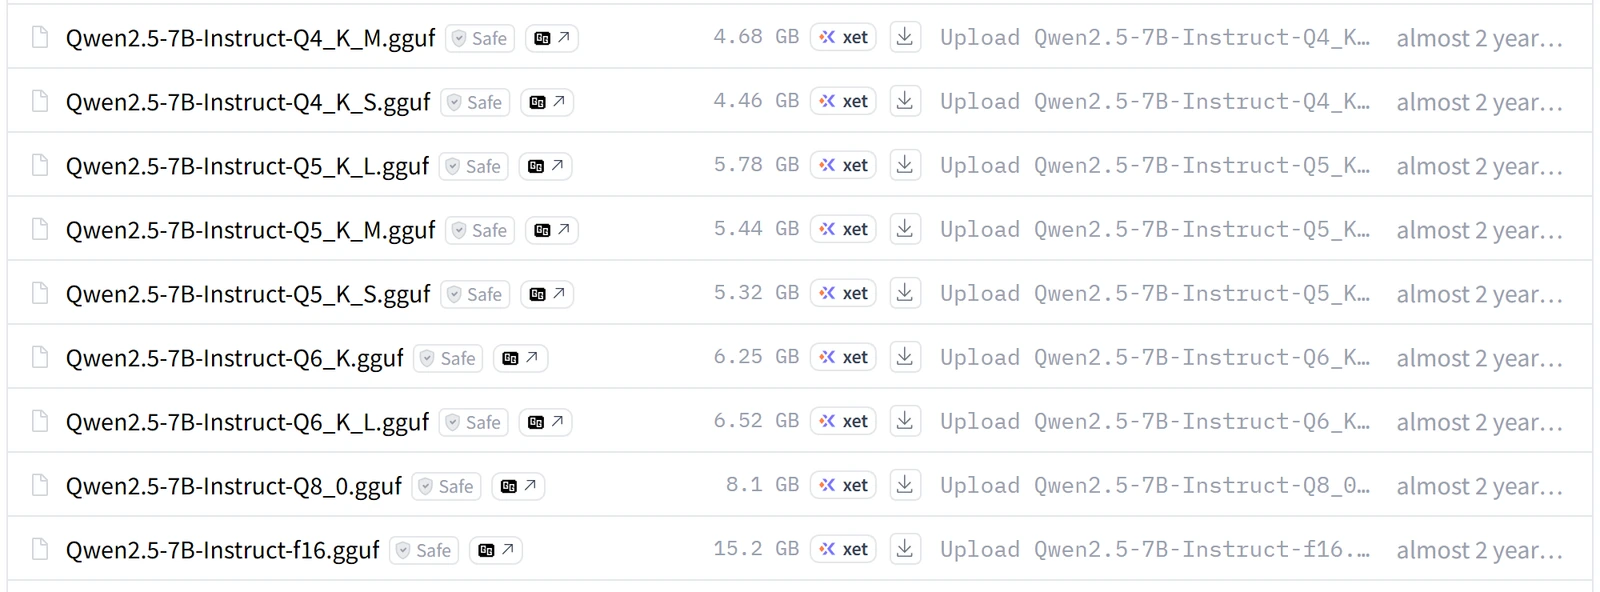
같은 7B 모델이 15.2GB 짜리도 있고 4.68GB 짜리도 있는 이유는 숫자 하나를 몇 바이트로 적느냐가 다르기 때문입니다. FP16·BF16·INT8·INT4 의 차이와 양자화의 원리, 그리고 7B 모델의 VRAM 을 직접 계산해 봅니다.
- 05
PyTorch에서 vLLM까지, LLM을 서버에 올리는 방법
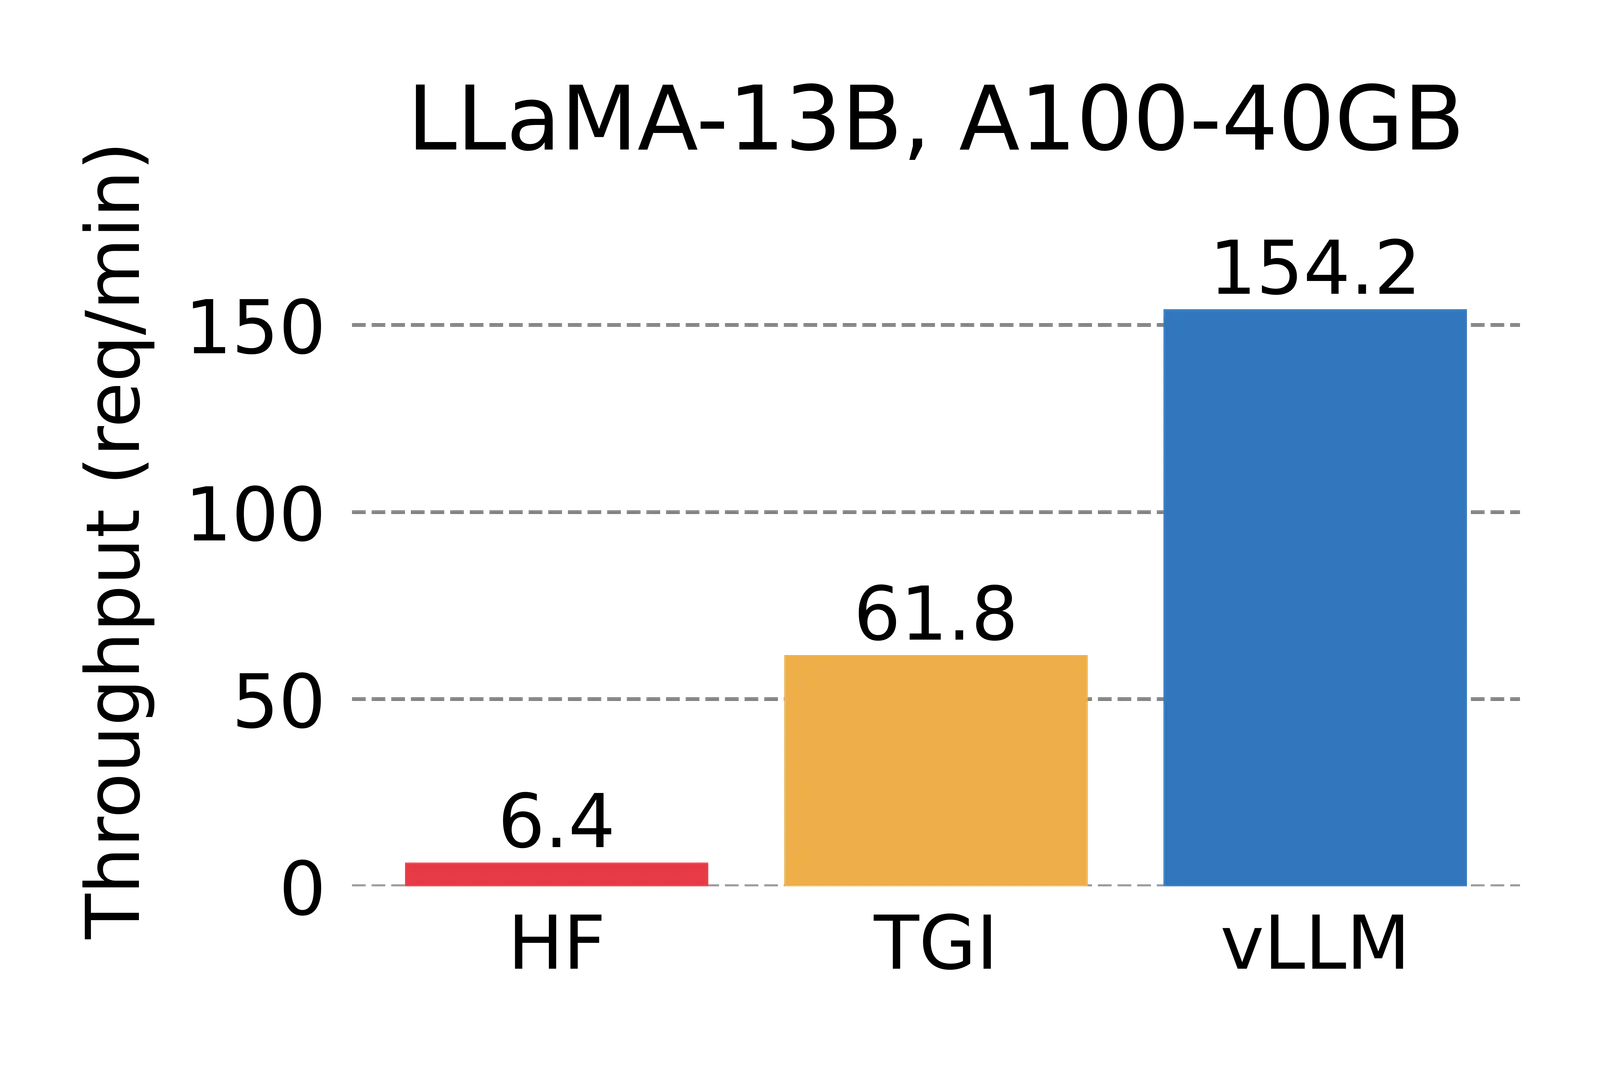
model.generate() 로 잘 돌던 모델이 동시 요청 앞에서 막히는 이유와, vLLM 이 PagedAttention·Continuous Batching 으로 그 문제를 어떻게 푸는지 코드와 함께 정리했습니다.
- 06
기업이 LLM을 여러 GPU에서 서비스하는 방법, Kubernetes·MIG·llm-d
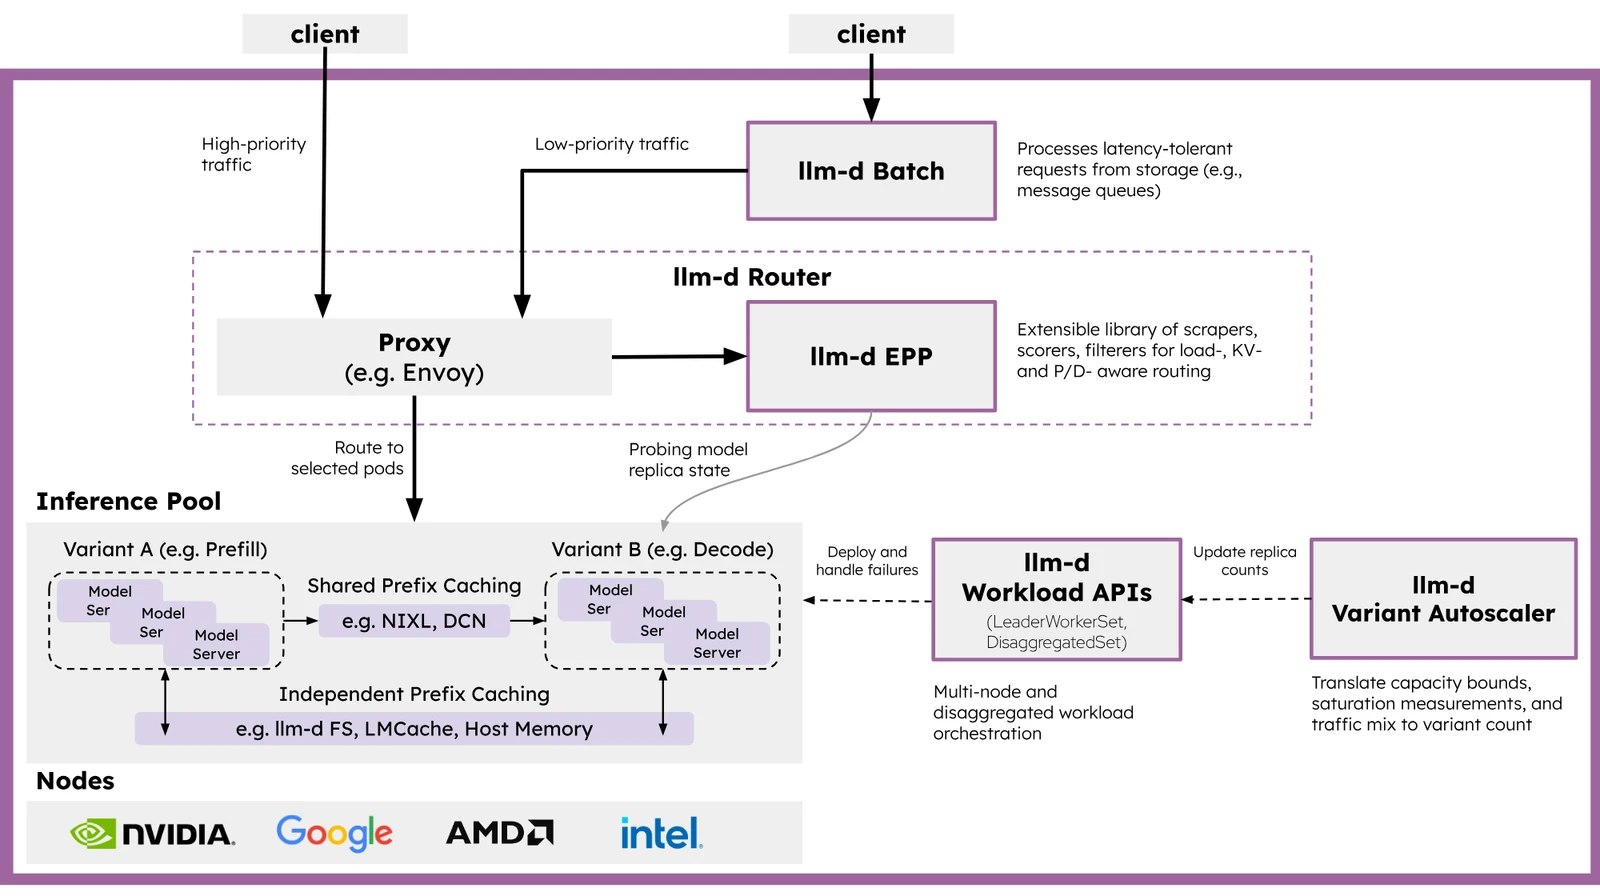
모델이 GPU 한 장에 안 들어가거나, 요청이 서버 한 대를 넘거나, GPU 가 남을 때 기업이 세우는 층 — Tensor Parallel·Kubernetes·MIG·llm-d — 이 각각 무슨 문제를 푸는지 정리했습니다.
- 07
모델 전체를 다시 학습하지 않는 Fine-tuning, LoRA와 QLoRA
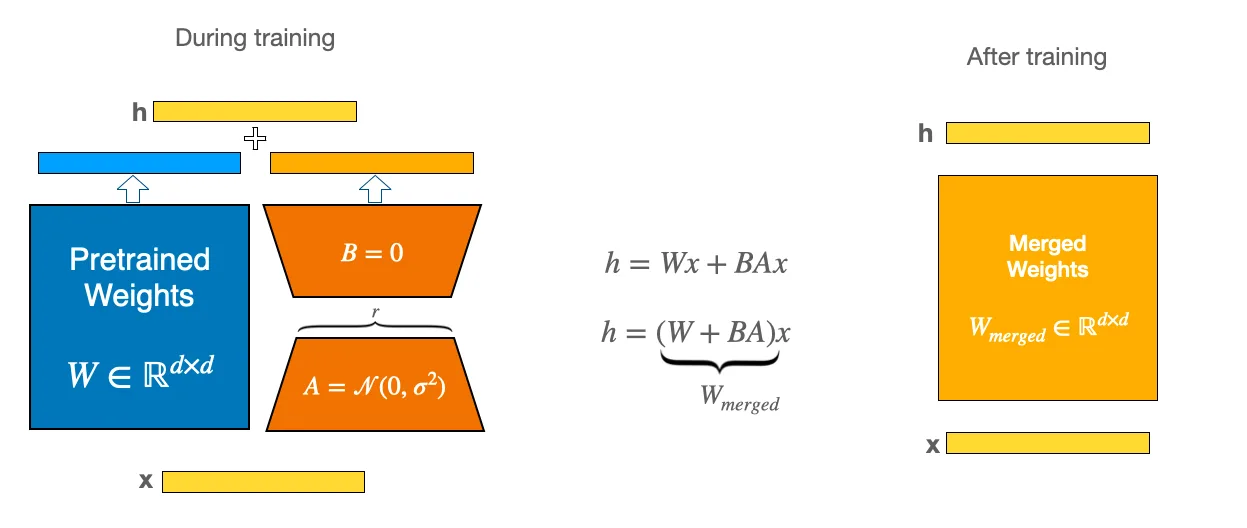
76억 개 파라미터를 전부 다시 학습하지 않고 곁에 붙인 작은 표 두 개만 학습하는 LoRA, 원본을 4비트로 눌러 놓는 QLoRA 를 실제 40.4MB 어댑터 파일로 계산해 가며 정리했습니다.
- 08
RAG는 어떻게 회사 문서를 LLM에게 알려줄까요?
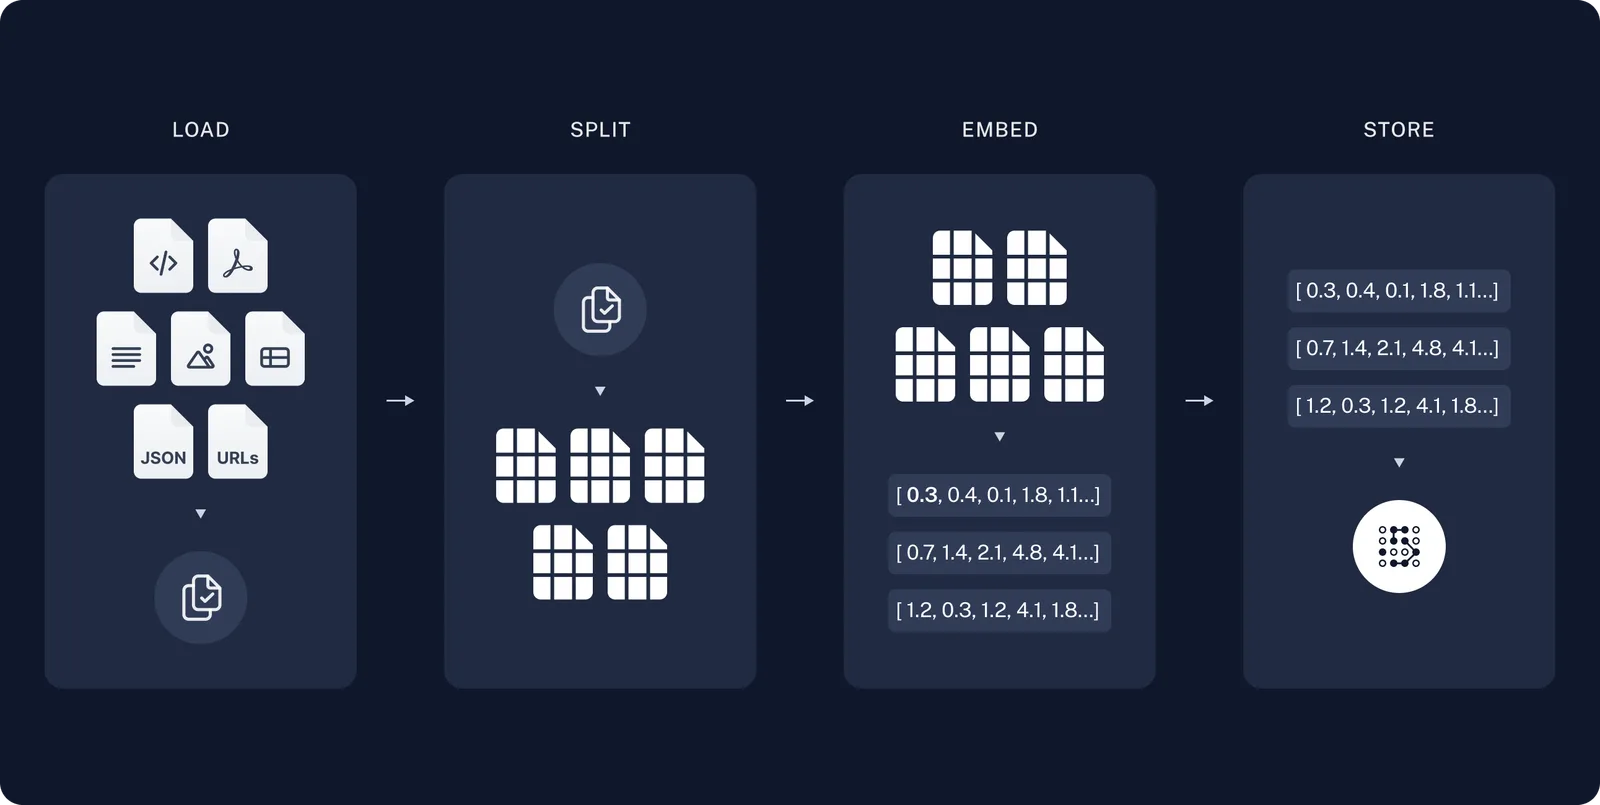
LLM 이 모르는 회사 문서를 파인튜닝 없이 답하게 만드는 RAG 의 구조 — 청킹·임베딩·벡터 DB·검색·Reranking — 를 색인과 질의 두 흐름으로 정리했습니다.
- 09
인터넷 없는 회사에서 생성형 AI를 쓰는 방법
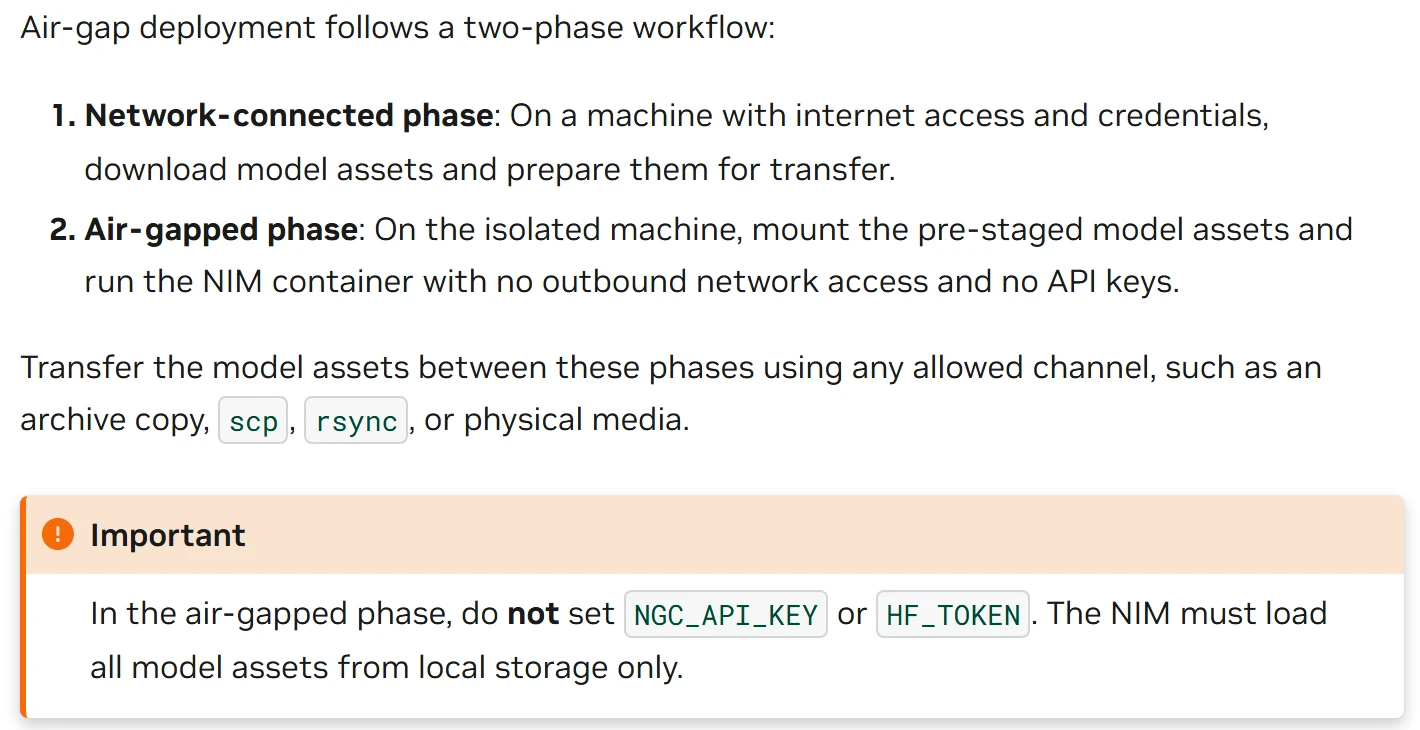
인터넷이 끊긴 폐쇄망에서도 생성형 AI 는 됩니다. LLM·임베딩 모델·벡터 DB·컨테이너 이미지·패키지를 어떻게 반입하고 들어온 뒤에는 무엇을 관리해야 하는지 정리했습니다.
- 10
AI 시대의 데이터는 어디에 저장될까요?
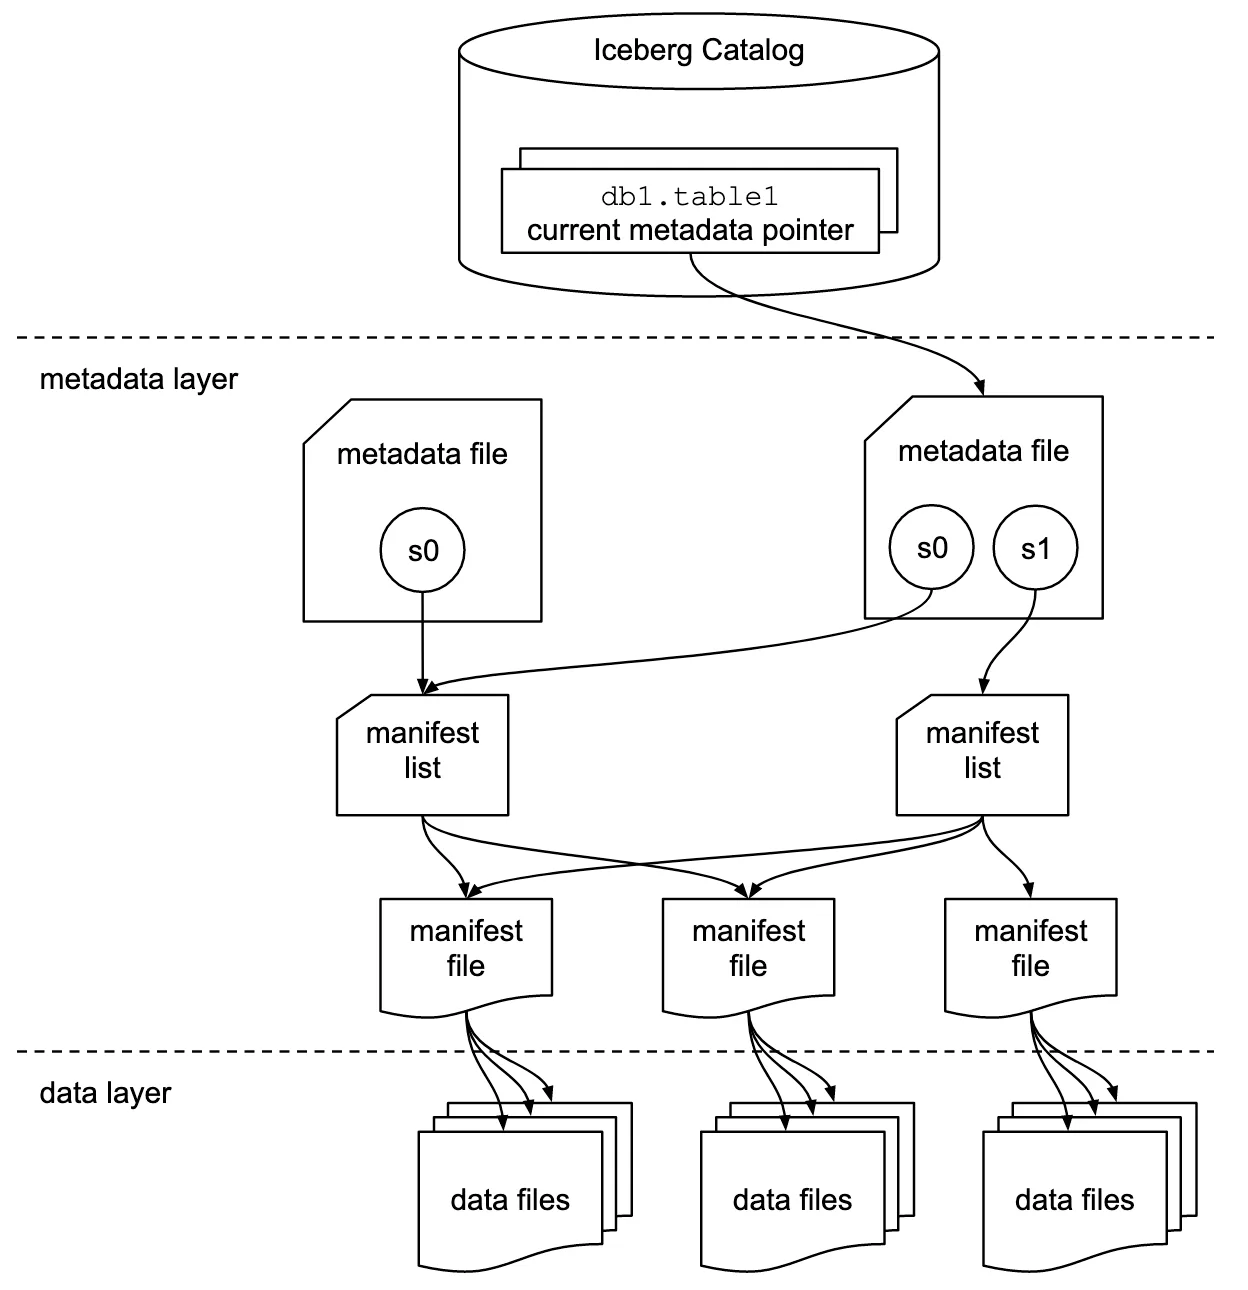
AI 에 쓰는 데이터는 DB 가 아니라 S3 에 Parquet 파일로 쌓입니다. 그 파일 더미를 테이블로 만드는 Iceberg, 큰 처리를 맡는 Spark, 빠른 질의를 맡는 StarRocks 의 역할을 한 장의 그림으로 정리했습니다.
- 11
모든 문제에 LLM이 필요한 것은 아니다
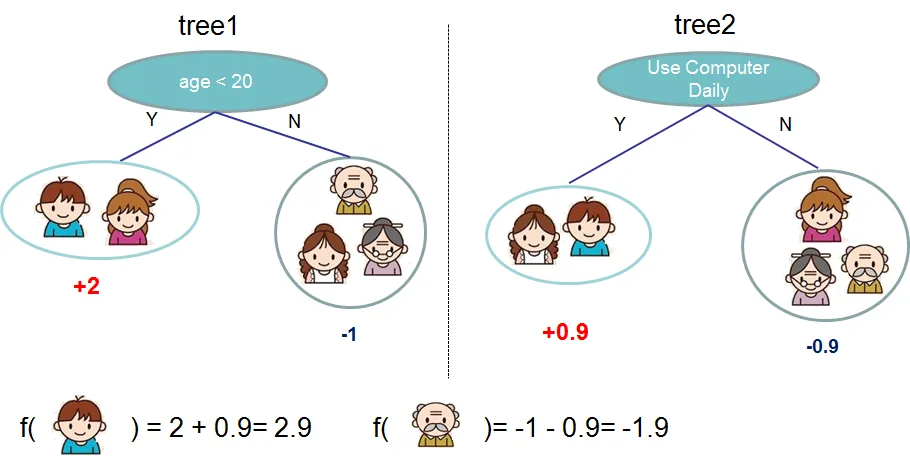
표 데이터에는 XGBoost, 시계열에는 TimesFM, 추천에는 Two-Tower. 기업 AI 프로젝트의 상당수가 LLM 이 아닌 이 세 모델로 해결되는 이유와 각각의 원리를 정리했습니다.
- 12
AI 모델은 배포가 끝이 아니다
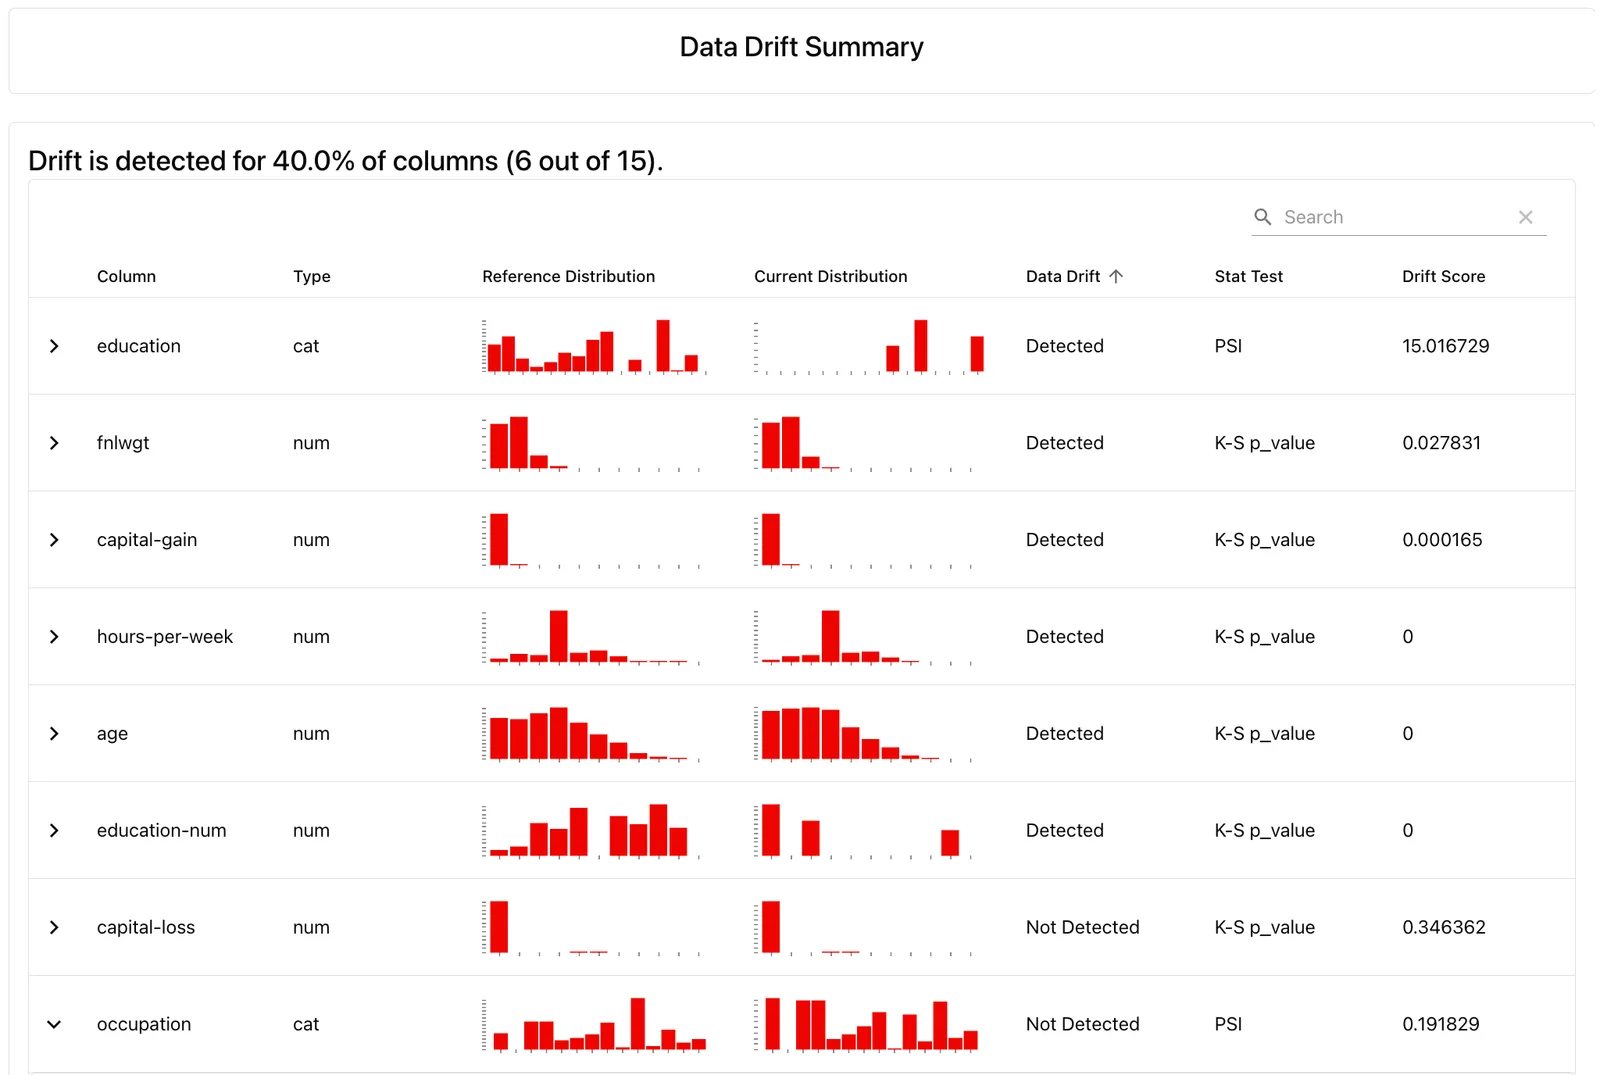
배포한 모델이 시간이 지나며 나빠지는 이유(Data Drift)와 그걸 재는 지표(Precision·Recall), 계속 돌리는 비용(TCO), 안에 뭐가 들었는지 아는 일(SBOM·SAST)까지 배포 이후의 운영을 정리했습니다.