같은 7B 모델이 15.2GB 짜리도 있고 4.68GB 짜리도 있는 이유는 숫자 하나를 몇 바이트로 적느냐가 다르기 때문입니다. FP16·BF16·INT8·INT4 의 차이와 양자화의 원리, 그리고 7B 모델의 VRAM 을 직접 계산해 봅니다.
Hugging Face 에서 같은 Qwen2.5-7B 인데 어떤 저장소는 15.2GB, 어떤 저장소는 4.68GB 짜리 파일을 올려 둔 걸 보셨을 겁니다. 저도 처음엔 작은 쪽이 뭔가 잘라낸 모델인 줄 알았습니다. 그런데 파라미터 수는 똑같이 76억 개입니다. 그럼 뭐가 다를까요? 숫자 하나를 몇 바이트로 적느냐가 다릅니다. 76억 개 × 2바이트면 15GB, × 0.5바이트면 3.8GB 입니다. 이 바이트 수를 줄이는 작업이 양자화인데 그 전에 GPU 메모리가 왜 그렇게 중요한지부터 잡고 가겠습니다.
왜 CPU 가 아니라 GPU 일까요
CPU 는 복잡한 명령을 순서대로 빠르게 처리하는 코어 몇 개~수십 개로 되어 있습니다. GPU 는 단순한 계산을 하는 코어 수천~수만 개를 묶어 같은 연산을 한꺼번에 합니다. LLM 의 Attention 계산과 가중치 표는 전부 행렬 곱이라 이 방식에 딱 맞습니다. 그래서 LLM 은 GPU 에서 돌립니다.
NPU 는 신경망 연산만을 위해 설계한 칩입니다. 폰의 Apple Neural Engine, Google 의 TPU, 국내 Rebellions·FuriosaAI 의 칩이 여기 속합니다. 범용성은 GPU 보다 낮고 전력 효율은 높습니다. 이 글은 데이터센터 기준으로 GPU 를 중심에 둡니다.
모델이 통째로 들어가야 하는 메모리 — VRAM
GPU 에는 CPU 의 RAM 과 별개로 자기 메모리가 붙어 있습니다. 이것이 VRAM 입니다. 소비자용 RTX 4090 은 24GB, 데이터센터용 H100 은 80GB 입니다. 그런데 왜 모델이 여기에 "통째로" 들어가야 할까요? LLM 은 토큰을 하나 만들 때마다 가중치 전부를 읽습니다. CPU RAM 에 두고 그때그때 옮기면 수십 배 느려집니다. 그래서 가중치가 VRAM 에 전부 올라가 있어야 합니다.
VRAM 을 쓰는 것은 가중치만이 아닙니다. 추론 중 앞 토큰의 Key·Value 를 저장해 두는 KV Cache 도 여기 올라가고 계산 중간값(활성화)도 공간을 차지합니다. 그래서 "7B 는 14GB 니까 16GB GPU 면 된다"는 계산은 보통 빗나갑니다. 가중치를 올리고 남는 공간이 KV Cache 몫이고 그 공간이 동시에 처리할 수 있는 요청 수를 정합니다.
숫자 하나가 몇 바이트인지 — 부동소수점
그럼 "숫자 하나당 2바이트"는 어디서 나온 걸까요? 파라미터는 실수이고 컴퓨터는 실수를 부동소수점으로 적습니다. 부호 비트 하나, 지수(범위) 비트 몇 개, 가수(정밀도) 비트 몇 개로 나눠 담는 방식입니다.
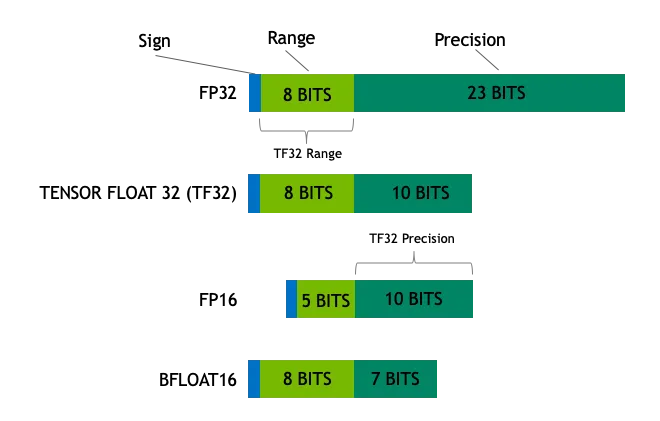
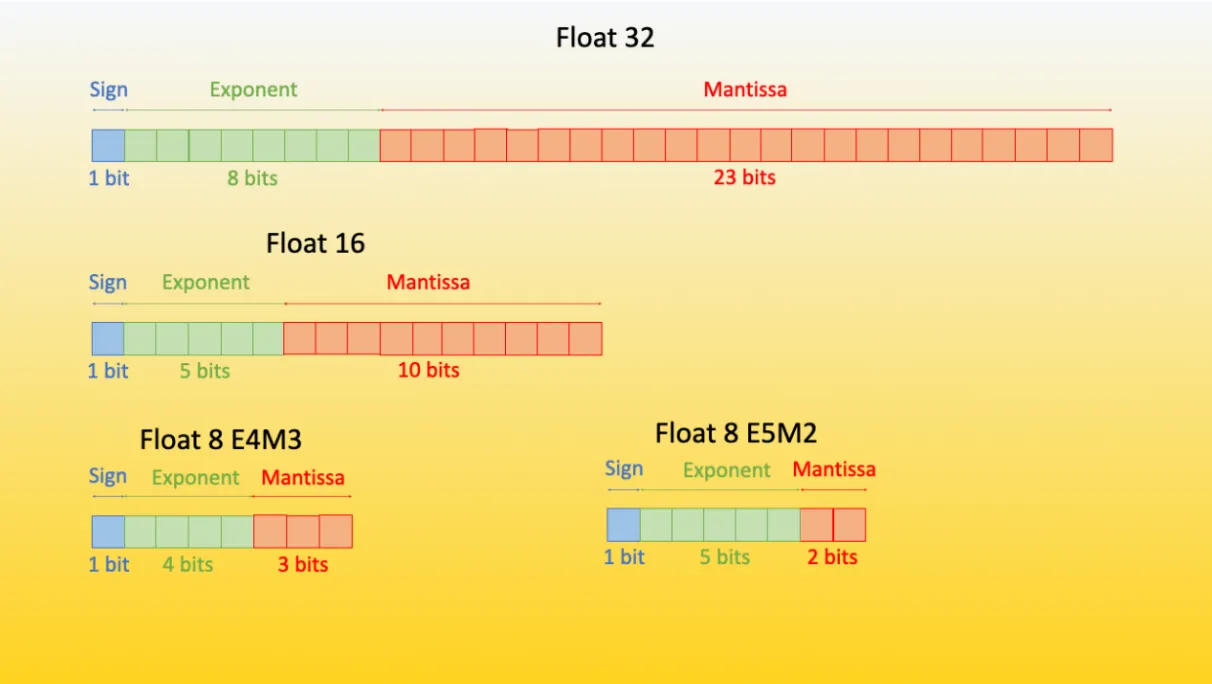
- FP32 — 32비트(4바이트). 지수 8 + 가수 23. 학습 시 기본값이었고 지금도 정밀 계산에 씁니다.
- FP16 — 16비트(2바이트). 지수 5 + 가수 10. 범위가 좁아 큰 값이 넘칩니다.
- BF16 — 16비트(2바이트). 지수 8 + 가수 7. FP32 와 같은 범위를 가지되 정밀도를 낮췄습니다. 요즘 모델 파일이 대부분 BF16 인 이유는 학습이 이 형식으로 이뤄졌기 때문입니다.
- FP8 — 8비트(1바이트). E4M3(지수 4·가수 3)와 E5M2 두 형식이 있고 H100 부터 하드웨어가 직접 지원합니다.
실수를 정수로 옮겨 적기 — 양자화
INT8·INT4 는 부동소수점이 아니라 정수입니다. 실수 파라미터를 정수로 바꾸는 작업이 양자화(Quantization)입니다.
여기서 제가 처음에 헷갈렸던 게 있습니다. "1m 를 100cm 로 바꾸는 것"처럼 단위만 바꾸는 건가 싶었는데 다릅니다. 단위 환산은 정보를 잃지 않지만 양자화는 잃습니다. 0.0123 과 0.0127 이 같은 정수로 떨어지는 식입니다. 정밀도를 포기하는 대신 바이트를 줄이는 거래입니다.
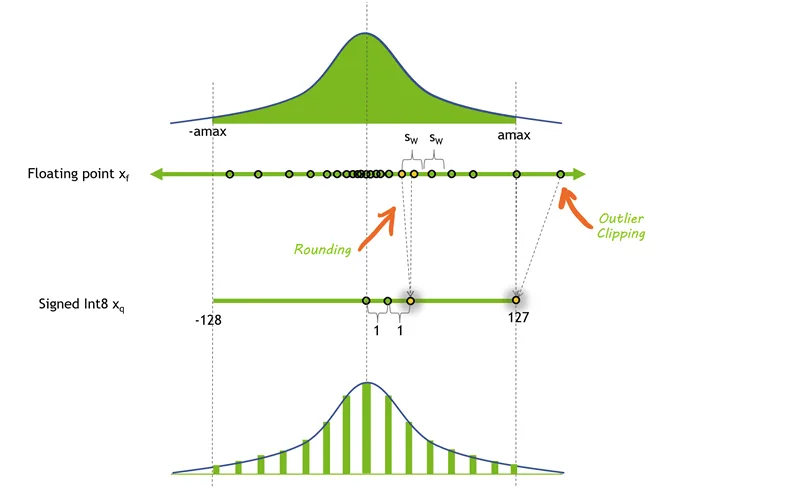
가장 단순한 방식은 이렇습니다. 어떤 가중치 표의 값이 −5.4 ~ +5.4 사이라고 하면, 이 범위를 INT8 의 −127 ~ 127 에 대응시킵니다. 이때 곱하는 배율이 scale 입니다(127 ÷ 5.4 ≈ 23.5). 각 값에 scale 을 곱해 반올림하면 정수가 됩니다. 실제로 쓸 때는 정수에 scale 을 나눠 실수로 되돌립니다. 되돌린 값은 원래 값과 조금 다르고 그 차이가 정확도 손실입니다.
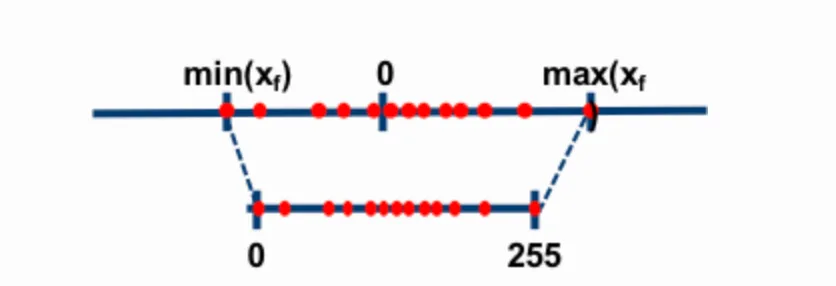
값이 0 을 중심으로 대칭이 아니면 범위를 그대로 0~255 에 대응시키고 어디가 0 인지를 따로 적어 둡니다. 이 위치가 zero-point 입니다. scale 과 zero-point 두 숫자만 있으면 정수 표를 실수 표로 되돌릴 수 있습니다. 그래서 양자화된 모델 파일은 정수 표 + 표마다 scale·zero-point 몇 개로 되어 있습니다.
7B 모델의 VRAM 을 직접 계산해 보면
이제 서두의 질문에 숫자로 답할 수 있습니다. 파라미터 76억 개(정확히 7,615,616,512 개)에 바이트 수를 곱하면 가중치 크기가 나옵니다.
7.6B × FP16/BF16 (2 Byte)  ≈ 15.2 GB
7.6B × INT8      (1 Byte)  ≈  7.6 GB
7.6B × INT4      (0.5 Byte) ≈  3.8 GB
실제 파일과 맞는지 볼까요? 아래는 같은 Qwen2.5-7B-Instruct 를 여러 정밀도로 양자화해 올려 둔 GGUF 저장소입니다.
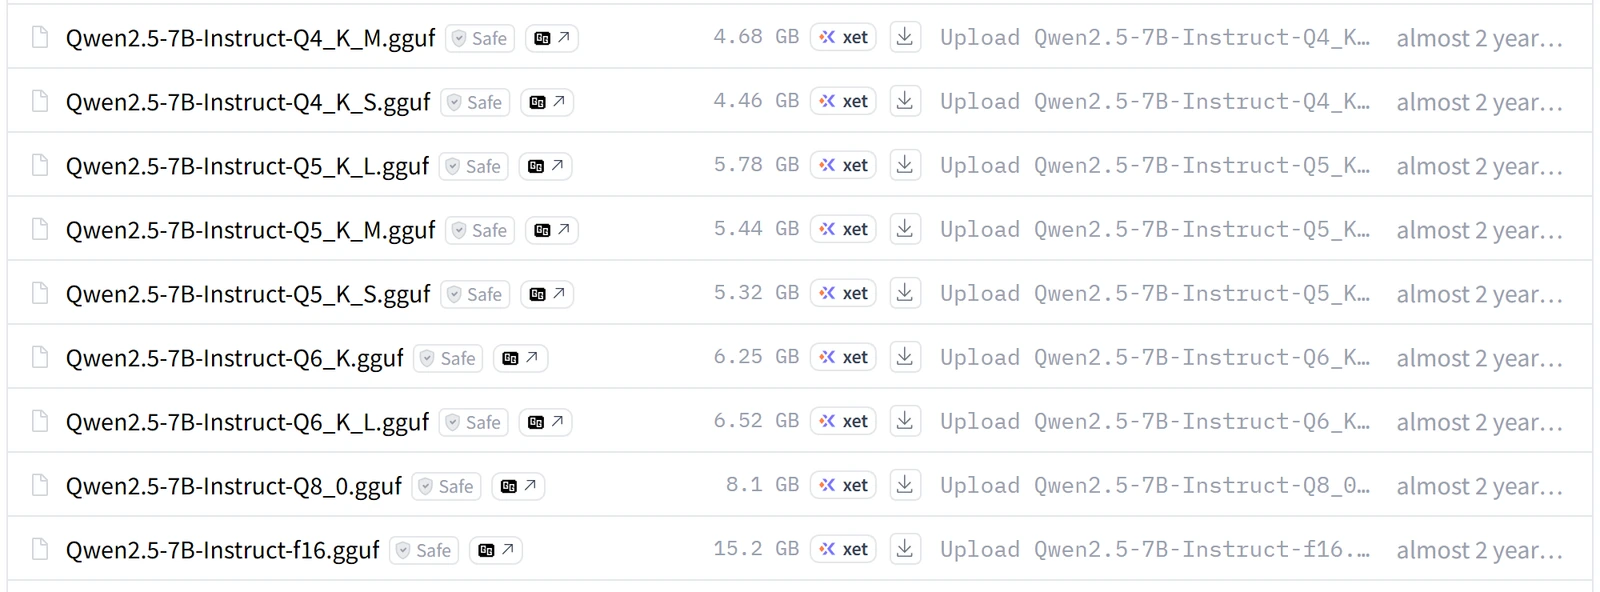
f16 15.2GB, Q8_0 8.1GB, Q4_K_M 4.68GB. 계산값보다 조금 큰 이유는 scale·zero-point 가 추가되고 민감한 표(임베딩·출력층)는 더 높은 정밀도로 남겨 두기 때문입니다. 표마다 정밀도를 다르게 두는 방식을 혼합 정밀도 양자화라고 부르고 K_M·K_S 같은 접미사가 그 배합을 뜻합니다.
이 표 하나로 "어느 GPU 에서 돌아가나"가 정해집니다. 24GB 인 RTX 4090 에는 f16 도 들어가고 8GB 노트북 GPU 라면 Q4 가 현실적인 선택입니다. 여기에 KV Cache 몫을 더해야 합니다.
그럼 무조건 작게 줄이면 될까요
정밀도를 낮출수록 메모리는 줄고 속도는 빨라집니다. 토큰 생성 단계는 메모리에서 읽는 바이트 수가 병목이라 바이트가 절반이면 토큰 생성도 대체로 그만큼 빨라집니다.
대신 품질은 계단식으로 떨어집니다. 경험적으로 INT8 은 원본과 거의 구분되지 않고 4비트도 잘 만든 방식이면 벤치마크 점수 차이가 작습니다. 3비트 아래로 내려가면 눈에 띄게 나빠집니다. 다만 이건 모델과 과제에 따라 다르니 실제로 써 볼 과제로 직접 재 봐야 합니다. 양자화는 공짜가 아니고 어디까지 잃어도 되는지를 정하는 일입니다.
여기까지가 모델 파일 자체의 이야기입니다. 다음 글에서는 이 파일을 실제로 Python 에서 불러 GPU 에 올려 보고 왜 vLLM 같은 추론 서버가 따로 필요한지 알아보겠습니다.
참고 자료
- 그림: A Gentle Introduction to 8-bit Matrix Multiplication — Hugging Face Blog (비트 배분 표·zero-point 양자화)
- 그림: Making LLMs even more accessible with bitsandbytes, 4-bit quantization and QLoRA — Hugging Face Blog (FP8 형식)
- 그림: Mastering LLM Techniques: Inference Optimization — NVIDIA Technical Blog
- 파일 목록 캡처: bartowski/Qwen2.5-7B-Instruct-GGUF — Hugging Face (Apache-2.0)