AI 에 쓰는 데이터는 DB 가 아니라 S3 에 Parquet 파일로 쌓입니다. 그 파일 더미를 테이블로 만드는 Iceberg, 큰 처리를 맡는 Spark, 빠른 질의를 맡는 StarRocks 의 역할을 한 장의 그림으로 정리했습니다.
RAG 에 넣을 문서, 파인튜닝에 쓸 대화 로그, 수요 예측 모델의 학습 데이터. 이런 것들은 회사 어디에 있을까요? 저는 당연히 데이터베이스에 있을 거라고 생각했는데 실제로 AI 팀이 데이터를 가져오는 곳은 DB 가 아니라 S3 같은 파일 저장소였습니다. 서비스 DB 에서 분석 질의를 돌리면 서비스가 느려지기 때문에, 분석·AI 용 데이터는 따로 싸게 쌓아 두는 곳이 생겼기 때문입니다. 그런데 파일로만 쌓아 두면 곧 다른 문제가 생기고 그걸 푸는 게 Iceberg 입니다.
Database·Data Warehouse·Data Lake 의 차이
서비스가 쓰는 데이터베이스(Postgres·MySQL)는 지금 이 순간의 상태를 정확하게, 한 건씩 빠르게 읽고 쓰는 데 맞춰져 있습니다. 여기서 "지난 3년 매출을 지역별로 집계"를 돌리면 서비스가 느려집니다. 그래서 분석용으로 데이터를 따로 복사해 두는 창고가 생겼고 그것이 Data Warehouse 입니다. 정해진 스키마로 정리해 넣고 SQL 로 집계합니다.
Data Lake 는 그보다 느슨합니다. 로그·이미지·JSON·CSV 를 정리하지 않은 채로 일단 싸게 다 넣어 두는 곳입니다. RAG 에 넣을 문서, 파인튜닝에 쓸 대화 로그, 예측 모델의 학습 데이터가 여기서 나옵니다. AI 는 정리된 표보다 원본이 필요한 경우가 많아 Data Lake 쪽이 출발점이 됩니다.
Data Lake 의 바닥인 Object Storage 와 Parquet
그럼 Data Lake 는 실제로 뭘로 만들까요? 바닥은 오브젝트 스토리지입니다. AWS 의 S3 가 대표이고 온프레미스에서는 MinIO·Ceph 가 같은 API 를 제공합니다. 폴더 구조가 있는 것처럼 보이지만 실제로는 "키 → 파일" 저장소이고 용량당 비용이 디스크보다 훨씬 쌉니다.
그 안에 넣는 파일 형식이 Parquet 입니다. CSV 는 행 단위인데 Parquet 은 열 단위로 저장합니다.
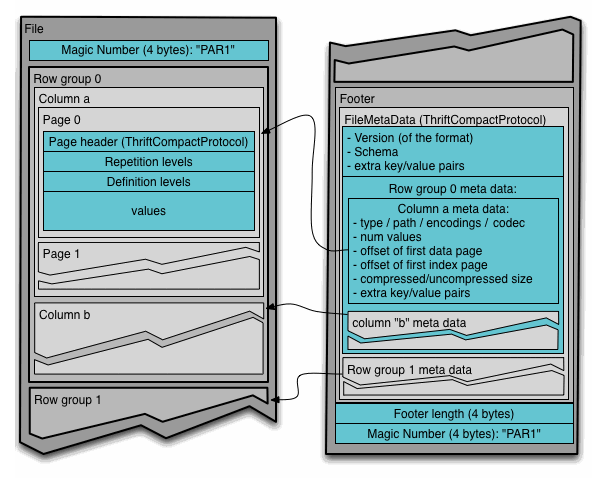
열 단위가 중요한 이유는 분석 질의가 보통 열 몇 개만 읽기 때문입니다. 100개 열 중 3개만 필요하면 그 3개 chunk 만 읽습니다. 같은 열은 값이 비슷해 압축도 잘 됩니다. 파일 끝의 footer 에 열마다 최솟값·최댓값이 적혀 있어 조건에 안 맞는 덩어리는 아예 건너뜁니다.
파일만 쌓아 두면 뭐가 문제일까요
S3 에 Parquet 을 폴더별로 쌓아 두면 처음엔 잘 됩니다. 그런데 곧 문제가 생깁니다. 어떤 파일이 이 테이블에 속하는지, 지난주 상태는 어땠는지, 열을 하나 추가하면 옛 파일은 어떻게 되는지, 두 작업이 동시에 쓰면 어떻게 되는지 — 파일 시스템은 아무것도 답해 주지 않습니다.
이 문제를 푸는 층이 Table Format 이고 Apache Iceberg 가 사실상 표준이 됐습니다. Netflix 가 2017년 만들어 2018년 Apache 에 기부했으며 2020년 최상위 프로젝트가 됐습니다. Iceberg 는 데이터 파일을 건드리지 않고 메타데이터 파일 층을 따로 둡니다.
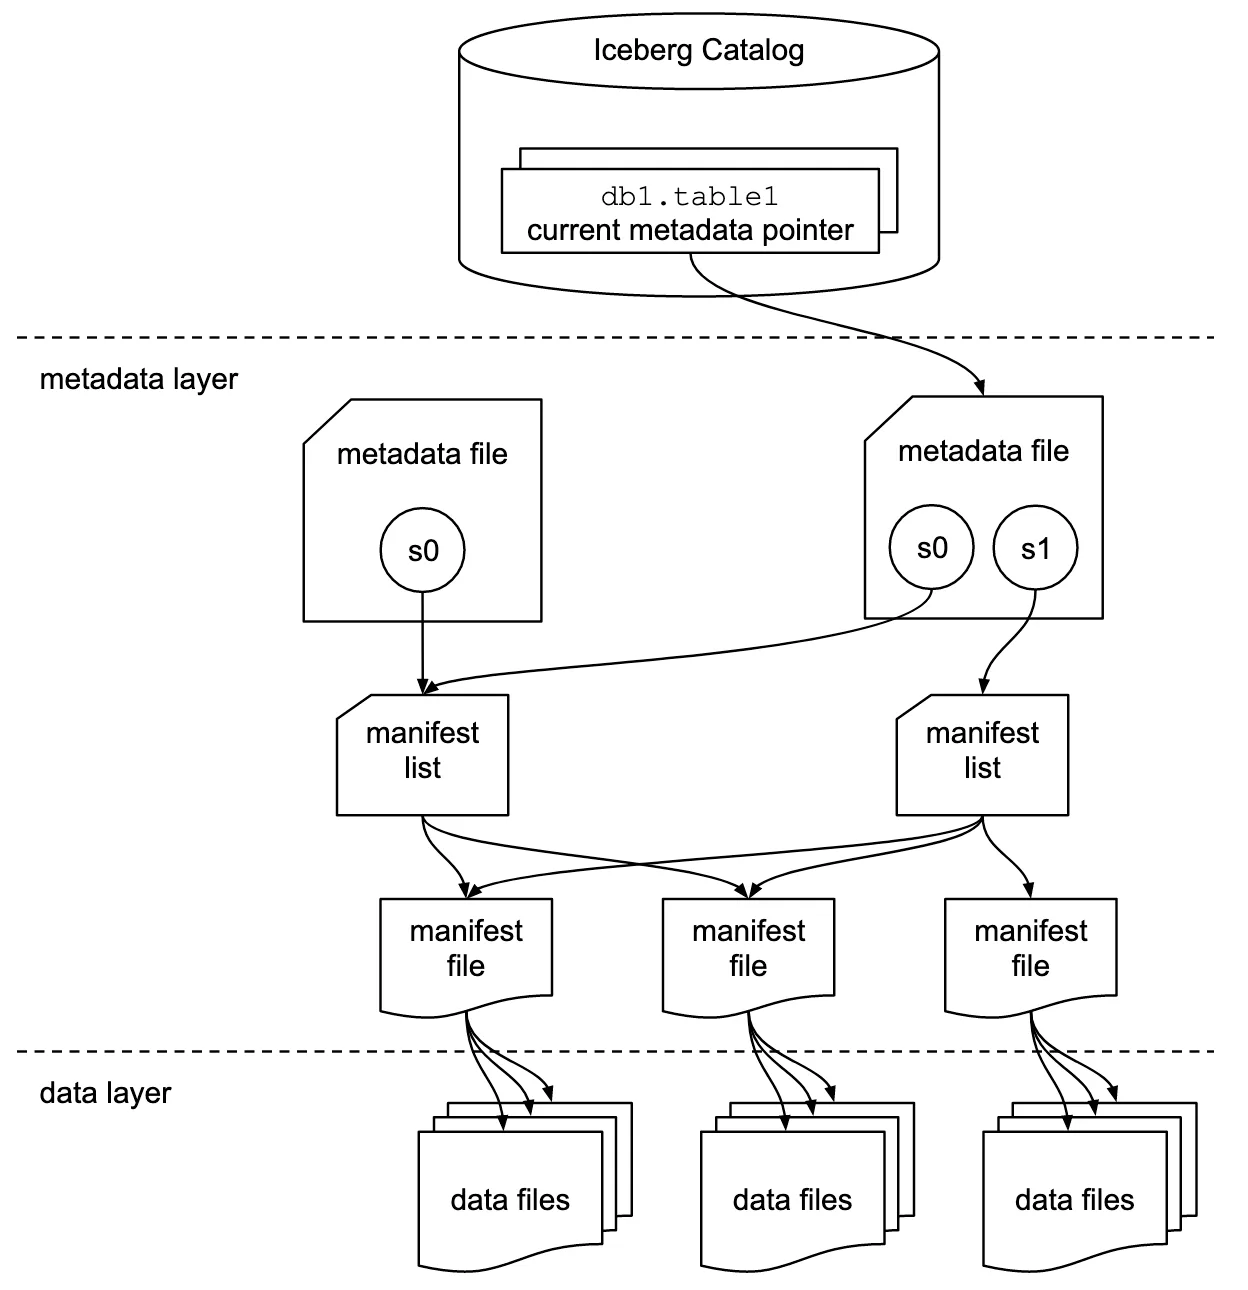
그림을 위에서 아래로 읽으면 이렇습니다. Catalog 는 테이블 이름마다 "지금 최신 metadata file 은 이것"이라는 포인터 하나를 갖습니다. metadata file 은 스키마와 스냅샷 목록을 담습니다. 스냅샷(s0, s1)마다 manifest list 가 있고 그 아래 manifest file 이 실제 데이터 파일 목록과 열별 통계를 갖습니다.
이 구조에서 세 가지가 공짜로 나옵니다.
- Snapshot — 쓰기가 끝날 때마다 새 스냅샷이 생깁니다. 옛 스냅샷의 파일은 그대로 두고 metadata 만 새로 씁니다. 그래서 쓰는 도중에 읽는 쪽은 이전 스냅샷을 일관되게 봅니다.
- Time Travel —
SELECT … FOR VERSION AS OF s0처럼 옛 스냅샷을 그대로 질의할 수 있습니다. 어제 학습한 모델이 무슨 데이터를 봤는지 재현할 때 씁니다. - Schema Evolution — 열 추가·이름 변경·타입 변경이 메타데이터 수정만으로 끝납니다. 열은 이름 대신 ID 로 추적되니 옛 파일을 다시 쓰지 않습니다.
이렇게 쌓은 것을 Lakehouse 라고 부릅니다
이렇게 S3 + Parquet + Iceberg 를 쌓으면 Data Lake 의 싼 저장에 Data Warehouse 의 테이블 성질(트랜잭션·스키마·SQL)이 얹힙니다. 이 형태를 Lakehouse 라고 부릅니다. 원본은 한 곳에만 두고 처리 엔진은 여러 개를 붙이는 게 핵심입니다. 그 엔진이 다음 두 가지입니다.
큰 처리는 Spark 가 합니다
첫 번째 엔진입니다. Apache Spark 는 데이터가 한 서버에 안 들어갈 때 여러 서버로 나눠 처리하는 분산 처리 엔진입니다. UC Berkeley 에서 시작해 2014년 Apache 최상위 프로젝트가 됐습니다. Python(PySpark)·SQL 로 씁니다.
Data Lake 에서 Spark 의 일은 ETL/ELT 입니다. 원본 로그를 읽어(Extract) 정제·조인·집계하고(Transform) Iceberg 테이블에 씁니다(Load). ETL 은 변환 후 적재, ELT 는 일단 적재 후 변환인데 Lakehouse 에서는 원본을 그대로 넣어 두고 나중에 변환하는 ELT 가 자연스럽습니다. RAG 의 문서 청킹·임베딩을 수백만 건 돌리는 것도 Spark 가 합니다. 수 시간짜리 배치가 Spark 의 영역입니다.
빠른 질의는 StarRocks 가 합니다
두 번째 엔진입니다. 배치 대신 대시보드에서 클릭할 때마다 초 단위로 답이 와야 하면 Spark 는 무겁습니다. 이 일은 OLAP 엔진이 맡습니다. Online Analytical Processing, 집계 질의를 실시간으로 처리하는 엔진입니다. StarRocks 는 그중 하나로 2023년 Linux Foundation 에 기부된 오픈소스 MPP(대규모 병렬 처리) 엔진입니다.
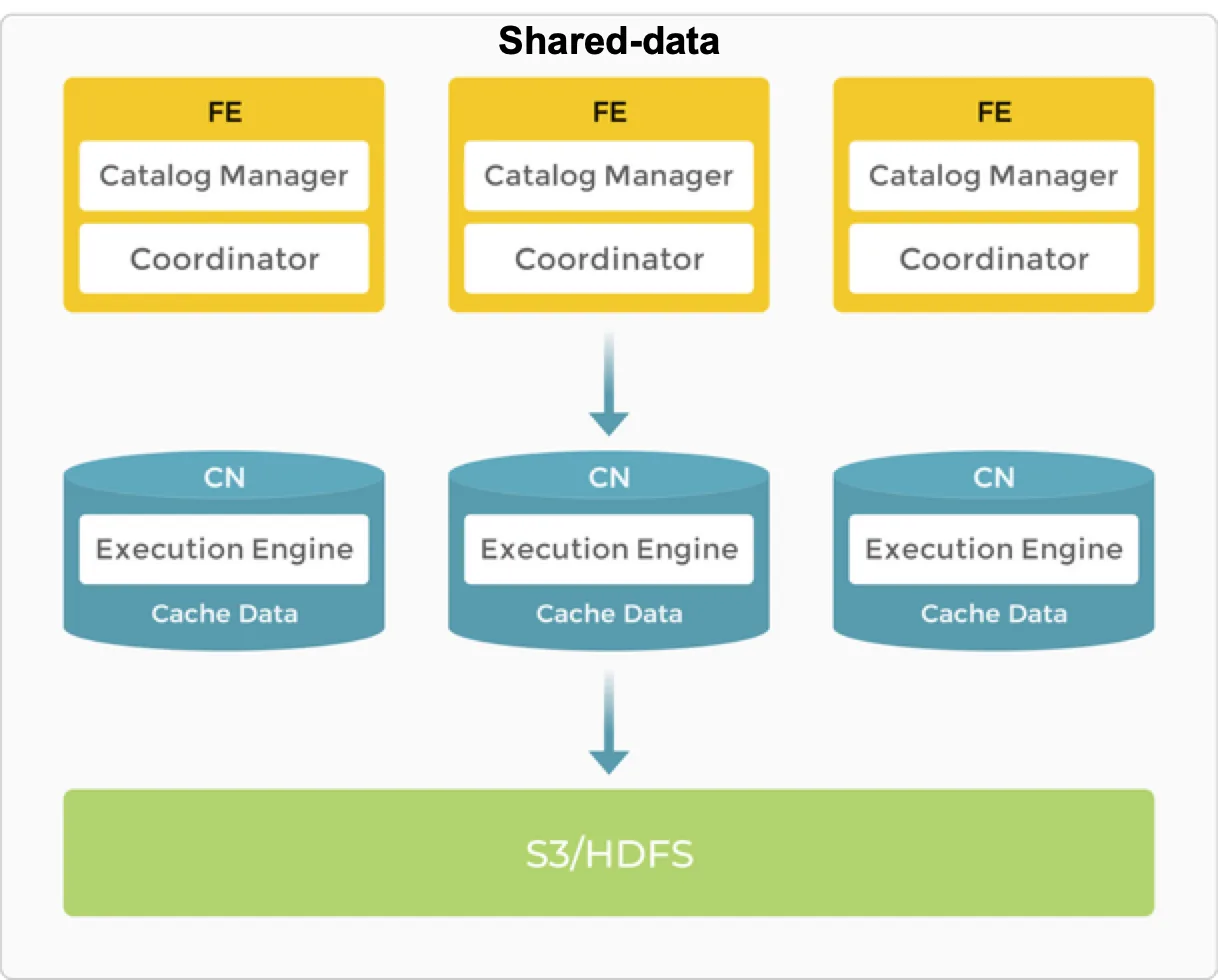
구조가 Lakehouse 와 잘 맞습니다. FE 가 SQL 을 받아 계획을 세우고 CN 노드들이 나눠 실행하는데 데이터는 자기 디스크가 아니라 S3 의 Iceberg 테이블을 그대로 읽습니다. 자주 읽는 부분만 CN 이 캐시합니다. Spark 가 써 둔 테이블을 StarRocks 가 복사 없이 바로 질의하는 구조입니다.
한 장으로 이으면
서두의 질문으로 돌아가서, 역할만 다시 정리하면 이렇습니다.
| 역할 | 시간 단위 | |
|---|---|---|
| S3 (Object Storage) | 싼 저장 | — |
| Parquet | 열 단위 파일 형식 | — |
| Iceberg | 파일 더미를 테이블로 | — |
| Spark | 대용량 변환·적재(ETL/ELT) | 분~시간 |
| StarRocks | 대시보드·즉석 집계(OLAP) | 초 |
애플리케이션·로그·DB 에서 나온 원본이 S3 에 Parquet 으로 쌓입니다. Iceberg 가 그걸 테이블로 만들고 Spark 가 정제해 다시 Iceberg 에 씁니다. StarRocks 가 그 테이블을 질의합니다. RAG 문서도, XGBoost 학습 데이터도, 모델 성능을 추적할 로그도 전부 이 위에 놓입니다. 그럼 그 데이터로 LLM 말고 어떤 모델을 만들까요? 다음 글에서 XGBoost·TimesFM·Two-Tower 에 대해서 알아보겠습니다.
참고 자료
- 그림: Iceberg Table Spec — Apache Iceberg (Apache-2.0)
- 그림: File Format — Apache Parquet (Apache-2.0)
- 그림: Architecture — StarRocks Docs (Apache-2.0)