76억 개 파라미터를 전부 다시 학습하지 않고 곁에 붙인 작은 표 두 개만 학습하는 LoRA, 원본을 4비트로 눌러 놓는 QLoRA 를 실제 40.4MB 어댑터 파일로 계산해 가며 정리했습니다.
"우리 데이터로 모델을 학습시키고 싶다"는 말을 들으면 저는 GPU 수십 장짜리 일이라고 생각했습니다. 76억 개 숫자를 전부 다시 고쳐야 하니까요. 그런데 Hugging Face 에서 -LoRA 가 붙은 저장소를 열어 보면 파일이 수십 MB 뿐입니다. 이게 어떻게 가능할까요? 원본은 그대로 두고 곁에 붙인 작은 표만 학습하기 때문입니다. 파인튜닝이 뭔지부터 잡고 왜 전체 학습이 비싼지, 그리고 LoRA 가 정확히 어디를 건드리는지 보겠습니다.
사전학습과 파인튜닝은 뭐가 다를까요
학습은 모델 안의 파라미터 값을 고치는 일입니다. 그 학습에도 단계가 있습니다. 인터넷 규모 텍스트로 처음부터 숫자를 정하는 것이 사전학습(Pre-training)이고 Qwen2.5-7B 처럼 이름에 접미사가 없는 모델이 이 결과물입니다. 사전학습된 모델을 특정 목적의 데이터로 조금 더 학습시키는 것이 파인튜닝입니다. 지시를 따르게 만드는 파인튜닝이 Instruction tuning 이고 -Instruct 접미사가 그 표시입니다.
전체를 다시 학습하면 왜 비쌀까요
파라미터 76억 개를 전부 고치는 Full Fine-tuning 은 추론과 메모리 규모가 다릅니다. 추론은 가중치만 있으면 되지만 학습은 가중치마다 기울기(얼마나 고칠지)와 옵티마이저 상태(고친 이력)를 같이 들고 있어야 합니다. 흔히 쓰는 Adam 옵티마이저와 혼합 정밀도 조합이면 파라미터 하나당 약 16바이트가 필요합니다. 7B 면 120GB 안팎이니 H100 두 장이 학습 시작 전에 이미 찹니다.
결과물도 문제입니다. 용도마다 15GB 짜리 모델이 하나씩 생깁니다. 고객 응대용, 코드 리뷰용, 요약용 모델을 따로 두면 저장도 서빙도 세 배입니다.
일부만 고치는 PEFT
그래서 나온 발상이 PEFT(Parameter-Efficient Fine-Tuning)입니다. 원본 파라미터는 얼려 두고 아주 일부만 학습하는 방법들을 묶어 부르는 이름이고 Hugging Face 의 peft 라이브러리 이름이기도 합니다. 원본이 안 바뀌니 기울기·옵티마이저 상태도 학습하는 일부에만 필요하고 결과물도 그 일부만 저장하면 됩니다. 이 "일부"를 원본 곁에 붙이는 작은 모듈로 만든 것을 어댑터라고 부릅니다.
큰 표 대신 얇은 표 두 개를 쓰는 LoRA
PEFT 중에서 사실상 표준이 된 것이 2021년 Microsoft 연구진이 제안한 LoRA(Low-Rank Adaptation)입니다.
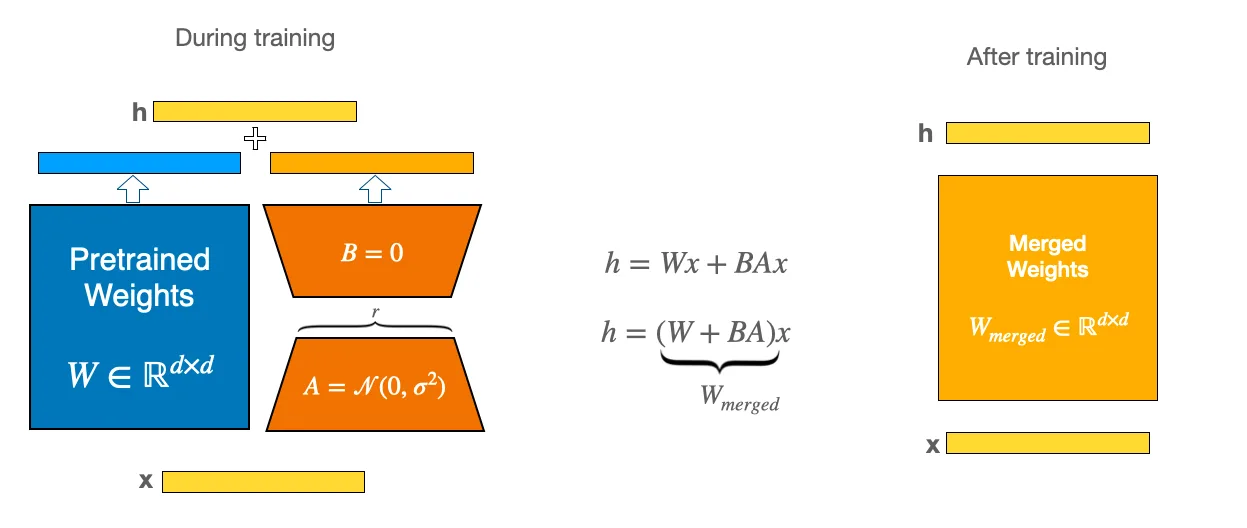
Qwen2.5-7B 의 q_proj.weight 는 3584 × 3584 표입니다. 이 표를 고치는 대신 그대로 두고(W), 곁에 3584 × r 표(A)와 r × 3584 표(B)를 새로 둡니다. 입력이 오면 W 를 통과한 결과와 A → B 를 통과한 결과를 더합니다. 학습은 A·B 만 합니다. 학습이 끝나면 B × A 를 W 에 더해 하나로 합칠 수도 있고(그림 오른쪽), 따로 두고 요청마다 골라 붙일 수도 있습니다.
Low-Rank 는 r 이 작다는 뜻입니다. 3584 × 3584 표를 통째로 바꾸면 1,280만 개 숫자를 고쳐야 하지만 r = 32 면 A·B 를 합쳐 23만 개입니다. 파인튜닝으로 바뀌어야 하는 부분이 실제로는 그 정도 자유도면 충분하다는 관찰이 LoRA 의 출발점입니다.
40.4MB 가 정말 나오는지 계산해 보면
서두의 의료 어댑터가 정말 그 계산대로인지 확인해 보겠습니다. adapter_config.json 은 이렇습니다. r: 32, target_modules: ["q_proj", "v_proj"]. 28개 층의 q_proj·v_proj 에만 LoRA 를 붙였다는 뜻입니다.
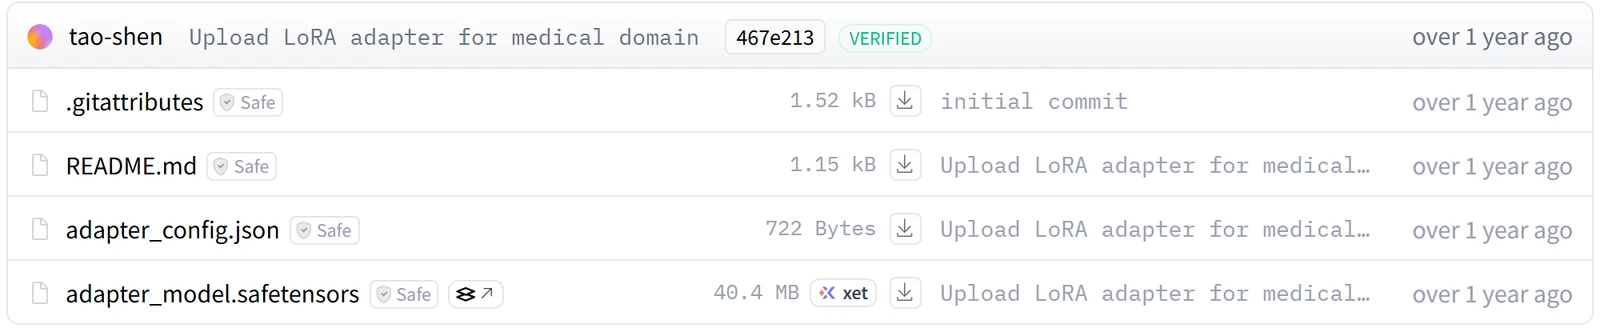
층마다 q_proj 몫 229,376 개 + v_proj 몫 131,072 개(v_proj 는 Key·Value 헤드를 4개만 두는 GQA 구조라 출력이 512 로 작습니다) = 360,448 개. 28층이면 약 1,009만 개이고 FP32 로 4바이트씩이면 40.4MB 입니다. 파일 크기와 정확히 맞습니다. 76억 개 중 0.13% 만 학습한 겁니다.
원본 저장소에 있던 config.json·tokenizer.json 이 여기엔 없습니다. 어댑터는 원본 위에 얹는 것이라 base_model_name_or_path 로 원본을 가리키기만 합니다. 서빙할 때는 vLLM 이 원본 하나를 올리고 요청마다 어댑터를 골라 붙이는 방식(--enable-lora)을 지원합니다. 15GB 모델 하나에 40MB 어댑터 수십 개를 얹어서 용도별 모델 수십 개처럼 쓰는 구조입니다.
원본을 4비트로 눌러 놓는 QLoRA
LoRA 로 학습할 파라미터는 줄었지만 얼린 원본 W 는 여전히 GPU 에 BF16 으로 올라가 있어야 합니다. 7B 면 15GB, 70B 면 140GB 입니다. 여기서 양자화가 떠오릅니다. 숫자 하나를 2바이트 대신 0.5바이트로 적어 메모리를 줄이는 기법입니다. 2023년 5월 University of Washington 의 Tim Dettmers 등이 낸 QLoRA 는 이 원본을 4비트로 눌러 올리고 그 위에 LoRA 어댑터만 BF16 으로 학습합니다.
논문은 세 가지를 새로 넣었습니다. 정규분포를 따르는 가중치에 맞춘 4비트 형식 NF4, 양자화의 scale 값 자체를 다시 양자화하는 Double Quantization, 학습 중 메모리가 갑자기 튈 때 CPU 로 넘기는 Paged Optimizers 입니다. 그 결과 65B 모델을 48GB GPU 한 장에서 파인튜닝했고 그렇게 만든 Guanaco 가 Vicuna 벤치마크에서 ChatGPT 의 99.3% 수준을 냈다고 보고했습니다.
양자화는 정밀도를 잃는 거래인데 그럼 QLoRA 도 품질이 떨어지지 않을까요? 얼린 원본만 4비트이고 학습하는 어댑터는 고정밀이라, 그 손실을 어댑터가 어느 정도 보정합니다. 소비자용 GPU 한 장으로 7B 를 파인튜닝하는 길이 이 논문에서 열렸습니다.
그런데 정말 파인튜닝이 필요한 걸까요
"우리 회사 문서를 모델에 넣고 싶다"는 요구에 파인튜닝을 먼저 떠올리기 쉬운데, 대부분은 RAG 가 맞습니다. 둘이 푸는 문제가 다르기 때문입니다.
| Fine-tuning (LoRA) | RAG | |
|---|---|---|
| 바꾸는 것 | 모델의 행동·말투·형식 | 모델에 주는 입력(문서) |
| 새 지식 반영 | 재학습 필요 | 문서 추가 즉시 |
| 출처 제시 | 어렵다 | 검색된 문서 그대로 |
| 잘 맞는 과제 | 도메인 용어·형식·스타일 고정 | 최신 정보·사내 문서 질의응답 |
| 비용 | GPU 학습 시간 | 임베딩·벡터 DB 운영 |
모델이 어떻게 답할지를 바꾸려면 파인튜닝, 무엇을 알고 답할지를 바꾸려면 RAG 입니다. 둘을 같이 쓰는 경우도 흔합니다. 의료 어댑터로 말투·용어를 잡고 RAG 로 최신 가이드라인을 넣는 식입니다. 다음 글에서 그 RAG 가 어떻게 돌아가는지 벡터 DB 부터 알아보겠습니다.