모델 파일 안의 숫자 표가 문장을 읽는 순서 — 토큰으로 자르고 임베딩으로 벡터를 만들고 Attention 으로 관계를 계산해 다음 토큰 하나를 고르기까지 — 를 Transformer Explainer 화면과 함께 따라갑니다.
LLM 모델 파일을 열어 보면 76억 개 숫자가 이름 붙은 표 모양으로 들어 있습니다(Qwen2.5-7B 기준). 그런데 숫자 표가 어떻게 "문장을 이해"할까요? 저는 이 대목이 제일 막연했습니다. 답부터 말하면, 모델은 문장을 이해하는 게 아니라 숫자를 곱해서 다음 토큰의 확률을 냅니다. 입력이 들어와서 확률 하나가 나오기까지 어떤 단계를 거치는지 보겠습니다.
먼저 글자를 토큰으로 자릅니다
모델은 한글도 영어도 직접 읽지 못합니다. 그래서 토크나이저가 글을 자주 나오는 조각 단위로 자릅니다. 이 조각이 토큰이고 조각마다 번호가 붙어 있습니다. 모델 저장소에 같이 들어있는 tokenizer.json 이 이 번호 사전입니다.
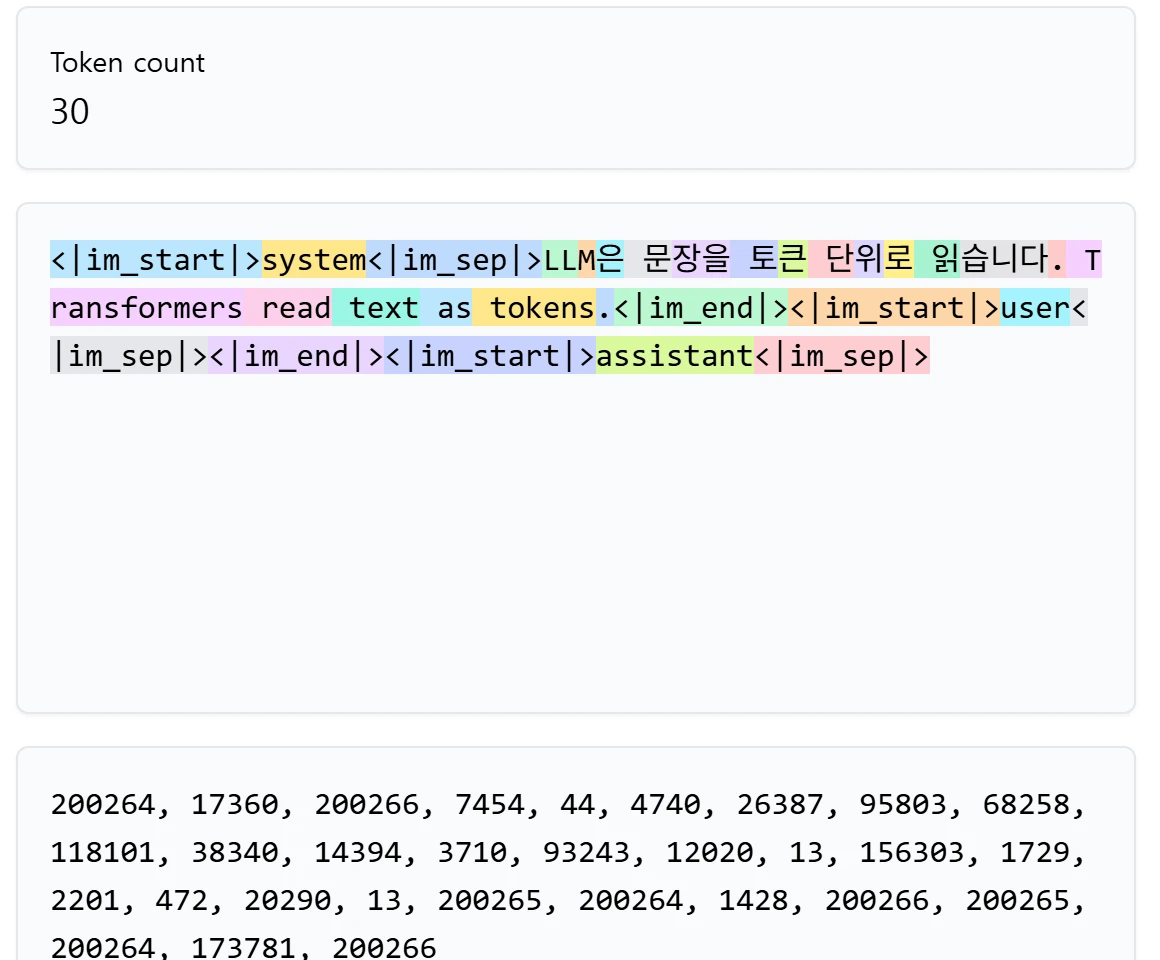
위 화면은 GPT-4o 토크나이저에 한 문장을 넣어 본 결과입니다. 영어는 단어 하나가 대체로 토큰 하나인데 한국어는 문장을·단위로 처럼 어절 단위로 잘리거나 더 잘게 쪼개집니다. 같은 뜻이라도 한국어가 토큰을 더 많이 씁니다. API 요금과 속도가 토큰 수 기준이라 이 차이는 그대로 비용이 됩니다. 아래 줄의 숫자 열(200264, 17360, …)이 모델에 실제로 들어가는 입력입니다.
번호를 좌표로 바꿉니다 — 임베딩
토큰 번호는 그냥 이름표라서 번호끼리 계산할 수가 없습니다. 그래서 번호마다 숫자 묶음을 하나씩 배정합니다. 이것이 임베딩이고 그 숫자 묶음이 벡터입니다. Qwen2.5-7B 파일의 model.embed_tokens.weight 가 [152064, 3584] 크기인 이유가 여기 있습니다. 어휘 152,064 개마다 3,584 차원 벡터가 한 줄씩 들어 있는 표입니다.
이 벡터는 학습 과정에서 뜻이 비슷한 토큰끼리 가까운 값을 갖도록 정해집니다. 그래서 "왕 − 남자 + 여자 ≈ 여왕" 같은 계산이 대충 맞아떨어집니다. RAG 의 벡터 DB 는 이 성질을 그대로 문서 검색에 씁니다.
같은 블록을 28번 지나갑니다 — Transformer
임베딩된 벡터 열은 Transformer 블록을 차례로 통과합니다. 2017년 6월 Google 연구진이 "Attention Is All You Need" 논문에서 제안한 구조인데 지금 나오는 LLM 은 거의 전부 이 구조의 변형입니다.
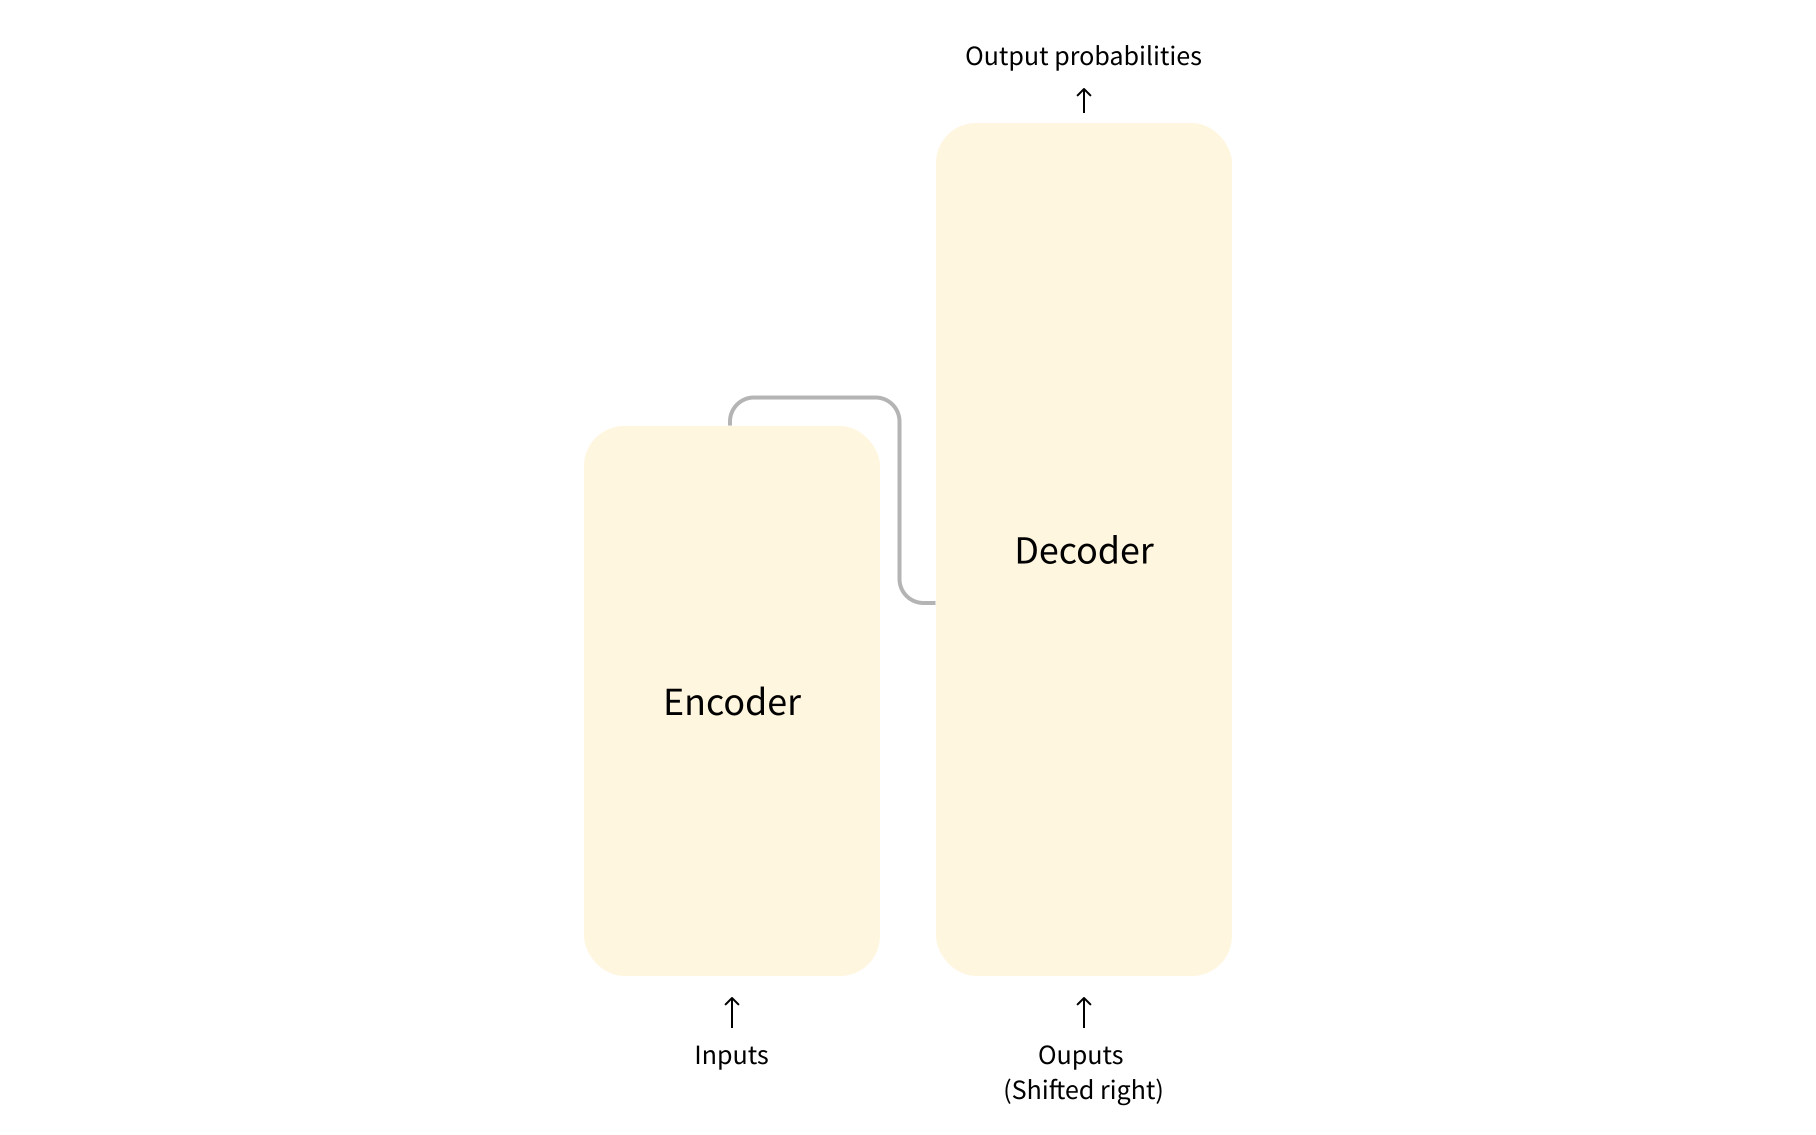
원래 논문은 입력을 읽는 인코더와 출력을 만드는 디코더 두 덩어리였습니다. GPT 계열과 Qwen·Llama 같은 요즘 LLM 은 디코더만 쌓습니다. 블록 하나는 Attention 층과 MLP 층으로 되어 있고 Qwen2.5-7B 는 이 블록을 28개 쌓았습니다. 파일 안의 model.layers.0 ~ model.layers.27 이 바로 그 28개입니다.
어느 토큰을 얼마나 볼지 정합니다 — Attention
블록의 핵심은 Attention 입니다. 문장 안의 각 토큰이 다른 토큰들을 얼마나 참고할지 가중치를 매기는 계산입니다. "그것을 먹었다"에서 "그것"이 앞의 "사과"를 가리킨다는 걸 알아내는 장치라고 생각하면 됩니다. 문장 안 토큰들끼리 서로 보는 것이라 Self-Attention 이라고 부릅니다.
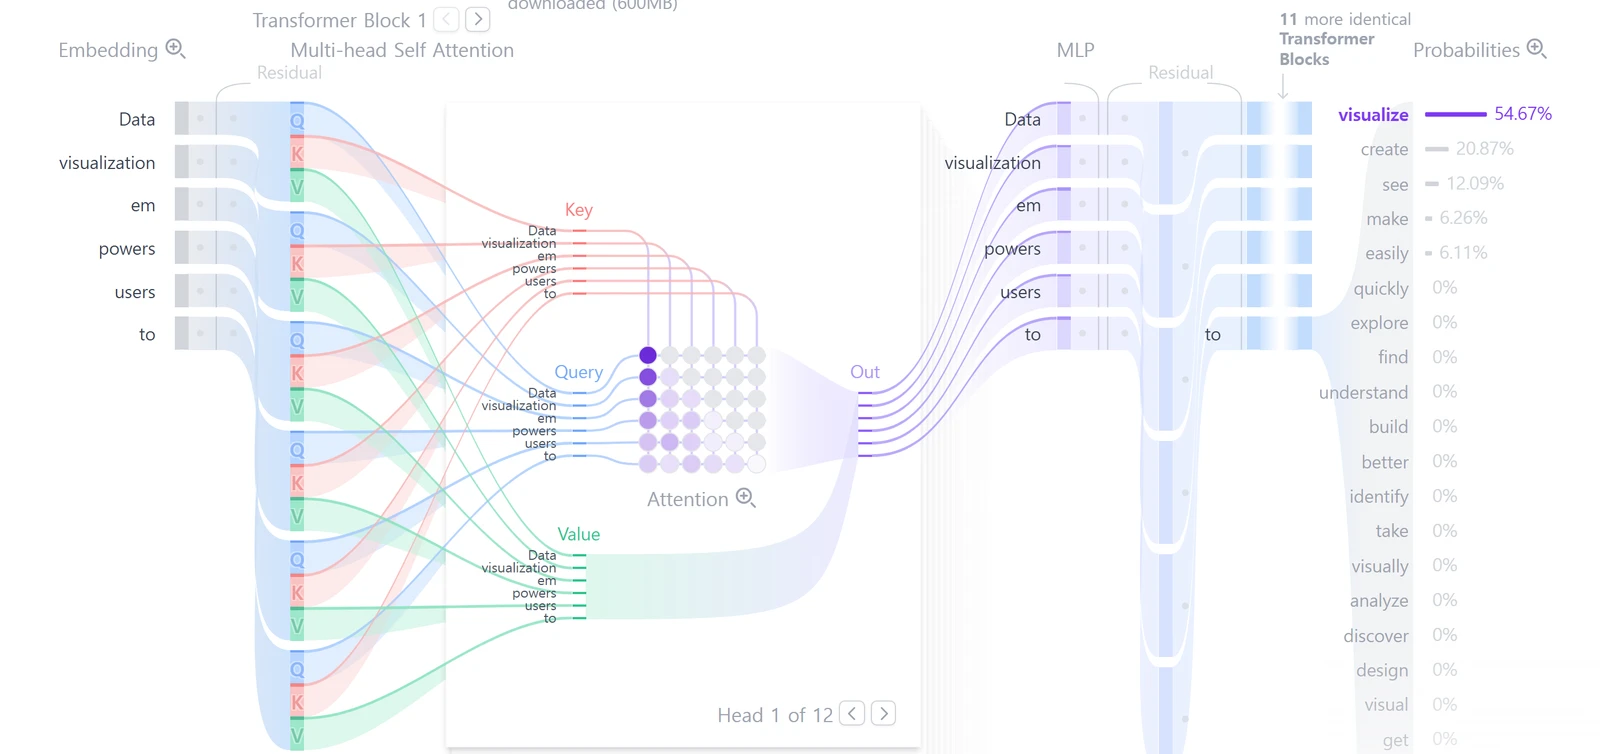
Georgia Tech 의 Transformer Explainer 화면입니다. 왼쪽 임베딩에서 토큰마다 세 갈래(Q·K·V)가 나오고 가운데 격자에서 Attention 이 계산되고 오른쪽 끝에서 다음 토큰 확률이 나옵니다. "Data visualization empowers users to" 다음에 visualize 가 54.67% 로 1등입니다.
왜 Q·K·V 세 개가 필요할까요
그림에서 벡터가 세 갈래로 갈라지는 게 보입니다. 토큰 벡터 하나를 그대로 쓰지 않고 세 가지 역할로 변환하는 건데, 이 변환 표가 파일 안의 q_proj·k_proj·v_proj 가중치입니다.
- Query — 내가 찾는 것. "나는 무엇을 참고해야 하지?"
- Key — 내가 가진 것의 색인. "나는 이런 정보를 갖고 있어"
- Value — 실제로 넘겨줄 내용
각 토큰의 Query 를 모든 토큰의 Key 와 내적하면 Attention Score 가 나옵니다. 점수가 높을수록 그 토큰을 많이 참고한다는 뜻입니다. 점수를 softmax 로 0~1 비율로 바꾼 뒤, 그 비율대로 Value 를 섞어 새 벡터를 만듭니다. 검색과 비슷합니다. 검색어(Q)를 색인(K)에 대조해 점수를 내고 점수 순으로 본문(V)을 가져오는 구조입니다.
그럼 왜 하나로 안 하고 셋으로 나눌까요? 역할이 다르기 때문입니다. "찾는 기준"과 "찾히는 기준"과 "실제 내용"이 같은 벡터일 필요는 없고 따로 학습시키는 편이 표현력이 큽니다.
같은 계산을 여러 관점으로 — Multi-Head
Attention 을 한 번만 하지 않고 여러 벌을 병렬로 합니다. 각각을 헤드라고 부릅니다. 한 헤드는 문법 관계를, 다른 헤드는 지시 관계를 보는 식으로 역할이 나뉩니다. Explainer 의 GPT-2 는 헤드가 12개, Qwen2.5-7B 는 num_attention_heads: 28 입니다.
여기까지 오면 파일 뷰어에서 이상했던 숫자 하나를 설명할 수 있습니다. q_proj.weight 는 [3584, 3584] 인데 k_proj.weight 는 [512, 3584] 로 작았습니다. Qwen 의 config.json 에 num_key_value_heads: 4 가 있는데 Query 헤드는 28개를 두고 Key·Value 헤드는 4개만 둬서 여러 Query 가 나눠 쓰는 방식(GQA)입니다. 그래서 K·V 표가 Q 표의 1/7 크기입니다. 이 설계가 추론 때 GPU 메모리에 쌓이는 KV Cache 크기를 결정합니다.
결국 확률 하나를 냅니다 — 다음 토큰 예측
28개 블록을 다 지나면 마지막 토큰 자리의 벡터를 어휘 152,064 개 각각에 대한 점수로 바꿉니다. softmax 를 거치면 확률이 되고 가장 높은 것을 고르거나 확률대로 뽑습니다. 이것이 다음 토큰 예측입니다.
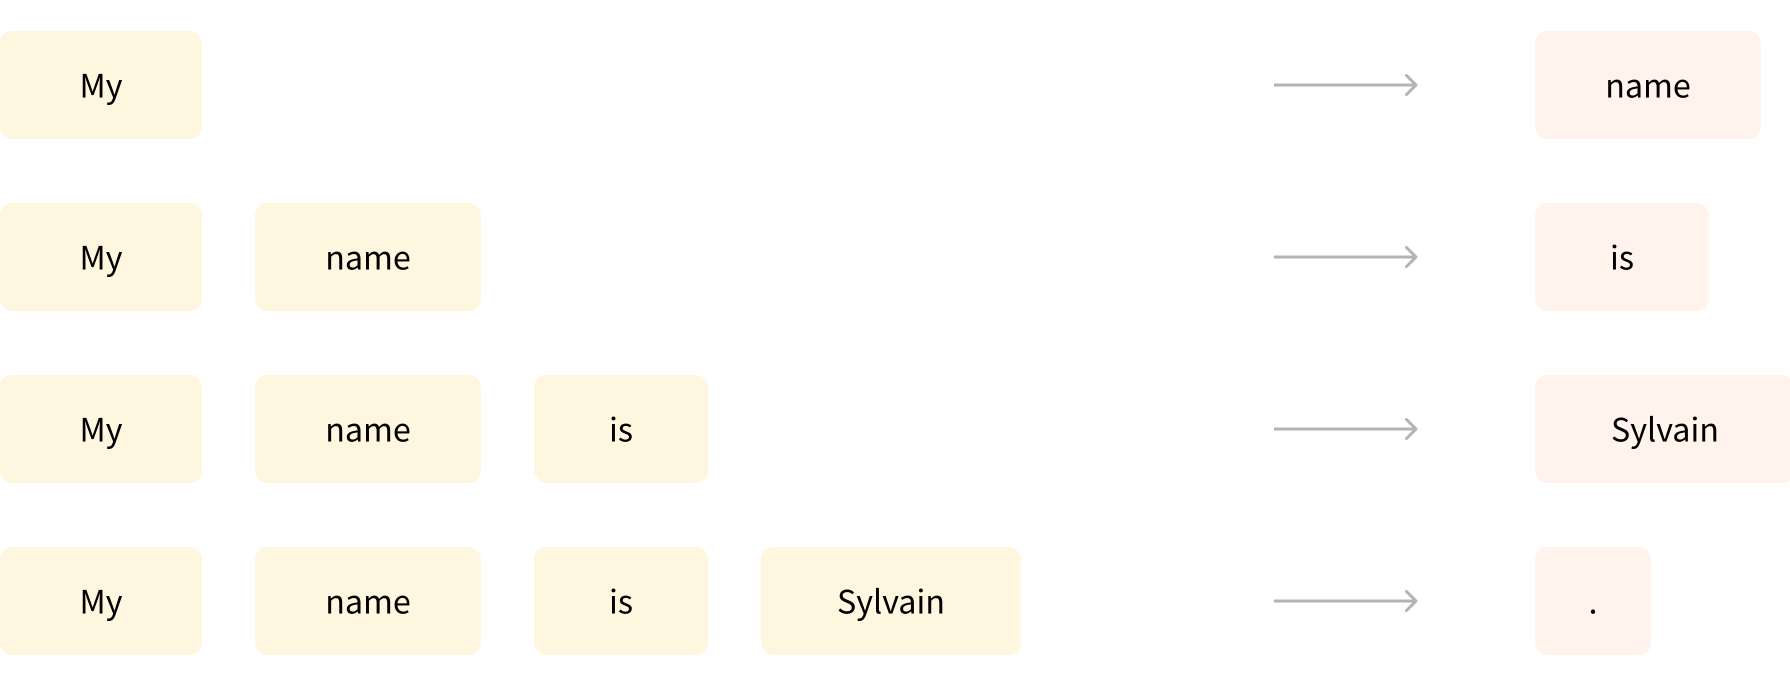
LLM 이 하는 일은 이것뿐입니다. 고른 토큰을 입력 끝에 붙이고 같은 계산을 다시 해서 다음 토큰을 고릅니다. 문장 하나를 만들려면 이 과정을 토큰 수만큼 반복해야 합니다. 그래서 답변이 한 번에 나오지 않고 한 글자씩 흘러나오는 겁니다. 그럼 이 반복을 어떻게 빠르게 할까요? 다음 글에서 Prefill·Decode·KV Cache 에 대해서 알아보겠습니다.