문서를 잔뜩 넣어 두고 질문할 때마다 다시 뒤지는 대신, LLM이 마크다운 위키를 직접 쓰고 계속 고쳐 나가는 방식입니다. 지식이 답변 안에서 매번 새로 만들어지는 게 아니라 파일로 쌓입니다.
질문마다 처음으로 돌아가는 RAG
문서와 LLM을 붙이는 흔한 방법은 RAG입니다. 파일을 올려 두면 질문할 때 관련 조각을 찾아와 답을 만듭니다. 잘 돌아가지만, LLM은 질문을 받을 때마다 그 지식을 처음부터 다시 발견합니다. 쌓이는 게 없습니다.
문서 다섯 개를 엮어야 답이 나오는 질문이라면, 물어볼 때마다 그 다섯 조각을 다시 찾아 다시 이어 붙입니다. 지난번에 발견한 연결도, 지난번에 눈치챈 모순도 그대로 사라집니다. NotebookLM이나 ChatGPT 파일 업로드도 대체로 이 구조입니다.
Andrej Karpathy가 2026년 4월에 공개한 llm-wiki.md는 여기에 층을 하나 더 놓자고 제안합니다. 원본과 나 사이에, LLM이 직접 쓰고 유지하는 마크다운 위키를 두는 겁니다. 새 자료가 들어오면 색인만 하는 게 아니라 읽고, 요약하고, 관련 페이지를 고치고, 기존 주장과 어긋나는 대목을 표시합니다. 지식을 매번 다시 캐내지 않고 한 번 정리해 둔 뒤 계속 최신으로 유지하는 쪽이죠.
원본·위키·스키마 세 층
구조는 세 층입니다.
원본은 직접 모은 자료입니다. 기사, 논문, 데이터 파일. 이 층은 불변이고 LLM은 읽기만 합니다. 위키는 LLM이 만든 마크다운 파일 묶음입니다. 요약, 인물·개념 페이지, 비교, 종합. 이 층은 LLM이 전부 소유합니다. 사람은 읽고, LLM이 씁니다. 스키마는 그 위키를 어떻게 굴릴지 적어 둔 문서입니다. Claude Code면 CLAUDE.md, Codex면 AGENTS.md.
스키마가 핵심입니다. 이 파일이 있어야 LLM이 그냥 대화하는 챗봇이 아니라 규율 있는 위키 관리자가 됩니다. 어떤 페이지 형식을 쓰는지, 자료를 넣을 때 무슨 순서로 처리하는지, 질문에 어떻게 답하는지를 적어 둡니다. 그리고 쓰다 보면 계속 손보게 되니, 사람과 LLM이 같이 다듬어 가는 문서이기도 하죠.
적재·질의·점검
작업은 세 가지입니다.
적재는 새 자료를 넣는 일입니다. LLM이 자료를 읽고, 요점을 같이 이야기하고, 요약 페이지를 쓰고, 색인을 갱신하고, 관련 개념 페이지를 손보고, 로그에 한 줄 남깁니다. 자료 하나가 위키 10~15쪽을 건드립니다.
질의는 위키에 질문하는 일입니다. 관련 페이지를 찾아 읽고 출처를 달아 답합니다. 여기서 한 가지가 중요합니다. 잘 나온 답은 다시 위키에 새 페이지로 넣습니다. 비교표 하나, 분석 하나가 채팅 기록에 묻혀 사라지지 않게요. 자료를 넣는 일뿐 아니라 내가 궁금해한 것들도 같이 쌓입니다.
점검은 주기적인 건강검진입니다. 페이지끼리 어긋나는 대목, 새 자료에 밀려 낡아 버린 주장, 아무 데서도 링크되지 않는 고아 페이지, 본문에 자주 나오는데 아직 제 페이지가 없는 개념. 이런 걸 훑어 달라고 시킵니다.
index.md 와 log.md
위키가 커지면 길잡이 파일 두 개가 필요합니다. index.md는 내용 목록입니다. 페이지마다 링크와 한 줄 요약을 달아 둔 카탈로그로, 적재할 때마다 갱신합니다. 질문이 들어오면 LLM이 색인을 먼저 읽고 필요한 페이지로 파고듭니다.
log.md는 시간순 기록입니다. 무슨 일을 언제 했는지만 계속 덧붙입니다. 여기에 작은 요령이 하나 붙습니다. 각 항목을 ## [2026-04-02] ingest | 기사 제목 처럼 같은 접두사로 시작하면, grep "^## \[" log.md | tail -5 한 줄로 최근 다섯 건이 나옵니다.
자료 100개, 페이지 수백 장 정도까지는 색인 파일만으로 충분하다는 게 원문의 관찰입니다. 임베딩 기반 검색 인프라를 세울 필요가 없다는 뜻이죠. 더 커지면 마크다운용 로컬 검색기를 붙입니다. 원문이 예로 든 qmd는 BM25와 벡터 검색을 섞고 재순위까지 로컬에서 도는 CLI로, 별 2만 9천 개가 붙어 있습니다.
문서 한 장이 앱이 됐다
원문은 구현이 아니라 아이디어 파일입니다. 디렉터리 구조도, 페이지 형식도 정해 주지 않고 "네 에이전트에게 이 문서를 통째로 붙여 넣고 같이 만들라"고 합니다. 그런데 공개 며칠 만에 이 패턴을 그대로 제품으로 만든 오픈소스가 나왔습니다.
nashsu/llm_wiki는 2026년 4월 8일에 올라와 지금 별 1만 6천 개를 넘겼습니다. Tauri v2와 React로 만든 데스크톱 앱인데, 세 층 구조와 세 작업, 위키링크 문법, 사람이 큐레이션하고 LLM이 유지하는 역할 분담을 그대로 지킵니다. 그 위에 지식 그래프 시각화, Louvain 커뮤니티 탐지, 사람이 검토하고 넘기는 리뷰 단계, MCP 서버를 얹었습니다. 라이선스는 GPLv3입니다.
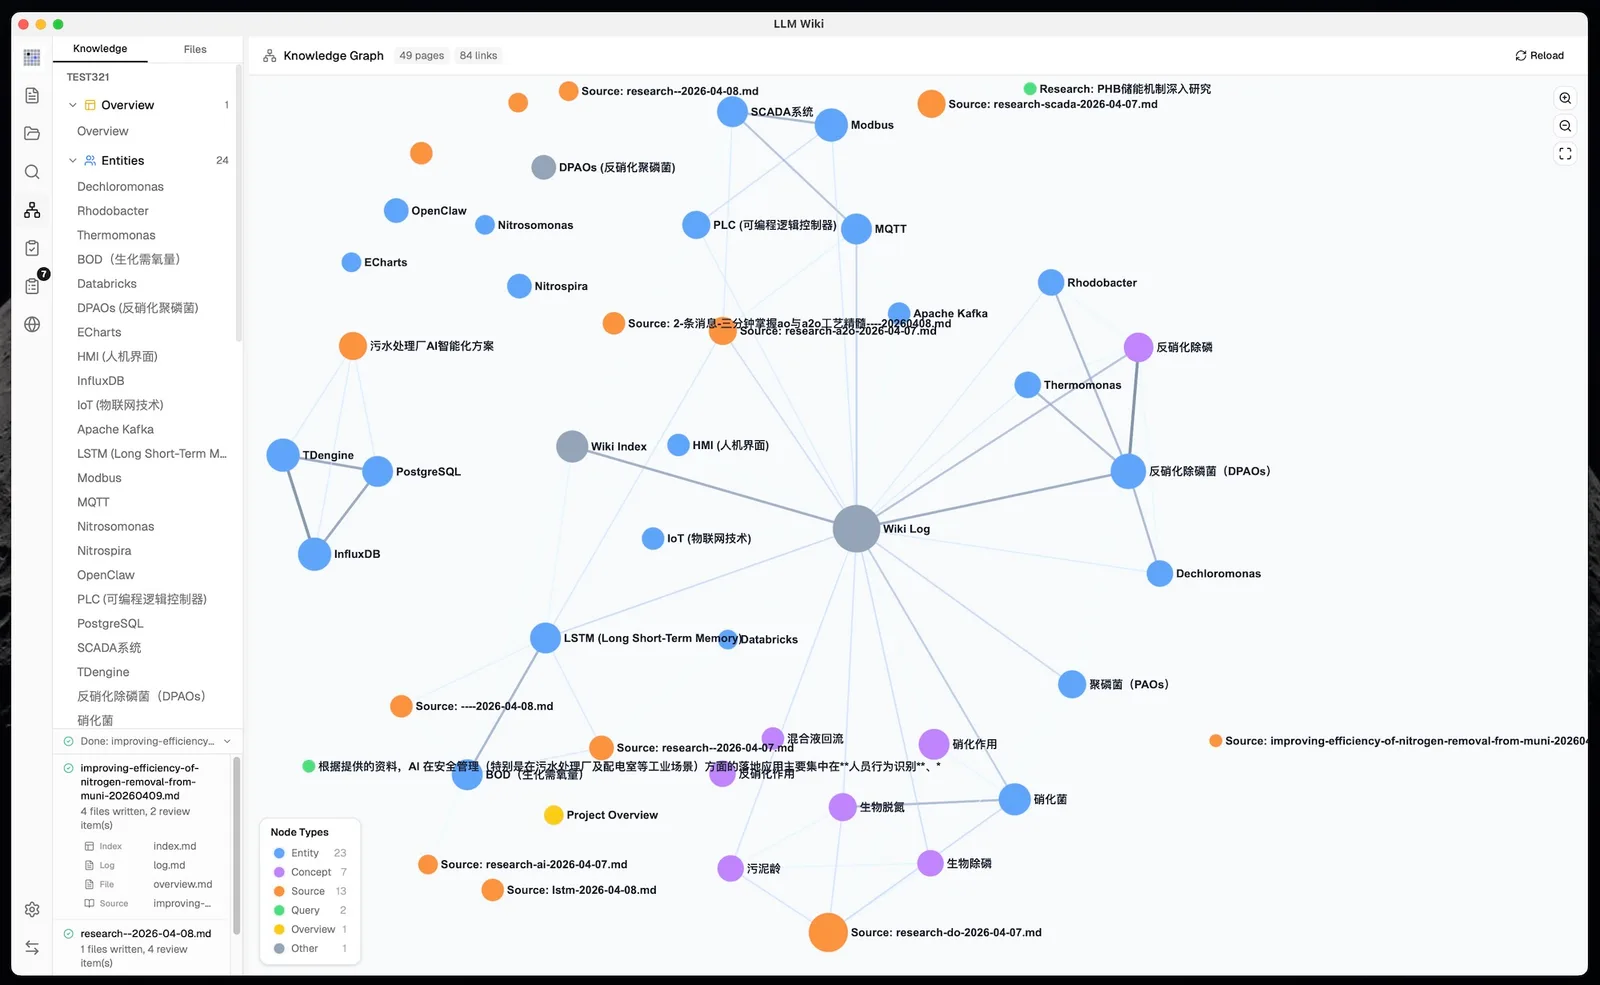
원문에서 Obsidian 그래프 뷰로 보라고 한 부분을 앱 안으로 끌고 들어온 셈입니다. 어느 페이지가 허브이고 어느 페이지가 고립돼 있는지가 한눈에 보입니다.
북키핑이 곧 이해라는 반론
Hacker News 토론에서 나온 반론이 날카롭습니다. Karpathy가 LLM에게 넘기라고 한 그 지겨운 일 — 정리하고, 상호참조를 걸고, 요약하는 일 — 이 바로 이해가 만들어지는 자리라는 겁니다. 그걸 넘기면 지식은 남고 이해는 안 남죠.
규모 이야기도 있습니다. 위키가 어느 선을 넘으면 검색·랭킹·청킹·권한 문제가 결국 되돌아온다는 지적입니다. RAG를 피해 왔더니 위키 안에서 RAG를 다시 만들게 된다는 거죠. 읽는 쪽과 쓰는 쪽이 같은 모델이라 오염이 티 나지 않게 번질 수 있다는 우려도 나왔습니다. AI가 쓴 페이지를 AI가 다시 요약하다 보면 디테일이 조금씩 뭉개진다는, 이른바 모델 붕괴 걱정입니다.
제텔카스텐과 견준 리뷰는 다른 지점을 짚습니다. LLM Wiki는 여러 자료를 주제 페이지로 모으는 방식이라, "이건 어느 페이지에 들어가야 하나"라는 분류 판단이 그대로 남습니다. 분류에서 벗어나려고 카드 단위로 쪼개는 제텔카스텐과는 취향이 갈리는 지점입니다.
코드에 하던 걸 지식에 한 것
읽고 나서 든 생각은, 새로운 기술이 하나도 없다는 점입니다. 마크다운 파일, 폴더, 위키링크, git. 전부 20년 된 것들이죠. 달라진 건 그걸 누가 유지하느냐 하나뿐입니다.
Karpathy는 이걸 1945년 Vannevar Bush의 Memex와 연결합니다. 문서 사이의 연결이 문서만큼 중요한 개인 지식 저장소라는 구상인데, Bush가 못 푼 문제가 "그 연결을 누가 계속 관리하느냐"였습니다. 사람이 위키를 버리는 이유도 같습니다. 관리 부담이 가치보다 빨리 늘어나거든요.
CLAUDE.md로 에이전트에게 코드베이스 규약을 알려 주는 일을 이미 하고 있다면, 이 패턴은 그 대상을 코드에서 지식으로 바꾼 것에 가깝습니다.
참고 자료
- 패턴 원문: Andrej Karpathy, "LLM Wiki" gist
- 화면 이미지 출처: nashsu/llm_wiki (GPL-3.0)