국내는 폐쇄망 규제와 정부의 독자 AI 파운데이션 모델 사업이 겹쳐 sLLM 자체 구축이 흐름이 됐는데, Menlo Ventures 가 집계한 세계 기업의 LLM 사용량에서 오픈소스 비중은 19% 에서 11% 로 줄었습니다. 두 숫자가 엇갈리는 이유와 코딩 에이전트에 붙일 수 있는 2026년의 오픈 웨이트 모델을 정리했습니다.
"우리도 sLLM 하나 구축해야 하지 않나"
요즘 국내 회의에서 자주 나오는 말입니다. 경쟁사가 자체 모델을 구축했다는 기사가 나오고 클라우드 API 에 코드를 보내는 게 보안 심사에 걸립니다. 그런데 요즘 소개되는 에이전트 개발 도구들은 대부분 Claude·GPT 같은 프런티어 API 를 전제로 합니다. 자체 모델로도 같은 개발 방식이 가능할까요? 먼저 "대세"라는 말이 어디까지 사실인지부터 확인해 보겠습니다.
용어부터 정리하면 sLLM 은 국내에서 주로 쓰는 표현으로 파라미터가 수십억 개 수준인 작은 언어 모델을 뜻합니다. 해외 자료의 SLM 과 같은 말입니다. 파라미터 크기 감각은 LLM 모델 뒤에 붙는 B 이야기에 정리해 뒀습니다.
소버린 AI 와 폐쇄망이 만든 한국의 흐름
국내에서 자체 구축이 흐름이 된 데는 두 가지 힘이 있습니다.
첫째는 규제와 폐쇄망입니다. 공공과 금융은 코드와 데이터를 외부 API 로 보내는 것 자체가 어렵습니다. 미래에셋증권이 네이버클라우드의 경량 모델 HyperCLOVA X DASH 를 기반으로 온프레미스 sLLM 을 구축한 사례처럼, 모델을 사내에 두는 것이 도입의 전제 조건이 됩니다. 이 환경에서 에이전트를 돌리는 방법은 폐쇄망 RAG 편에서 다뤘습니다.
둘째는 정부의 독자 AI 파운데이션 모델 사업입니다. 2025년 8월에 네이버클라우드·NC AI·업스테이지·SK텔레콤·LG AI연구원 다섯 팀이 선정됐습니다. 2026년 1월 15일 1차 평가에서 LG AI연구원·SK텔레콤·업스테이지가 2차에 진출했고 네이버클라우드와 NC AI 는 탈락했습니다. 탈락 사유가 흥미롭습니다. 정부가 "독자 모델"을 아키텍처 설계·데이터 확보·사전학습을 전부 직접 한 모델로 엄격히 정의해서 해외 모델을 미세조정한 방식은 자율성 기준에 걸렸습니다. 2026년 8월 2차 평가에서도 세 팀이 다음 단계로 갔습니다. 이 사업이 국산 오픈 웨이트 모델(EXAONE·A.X·Solar 계열)의 공급을 만들고 있습니다.
세계 기업에서는 오히려 줄어든 오픈소스 비중
그런데 세계 기업 전체를 보면 그림이 다릅니다. Menlo Ventures 가 2025년 12월 9일에 낸 기업 생성형 AI 보고서의 도표입니다.
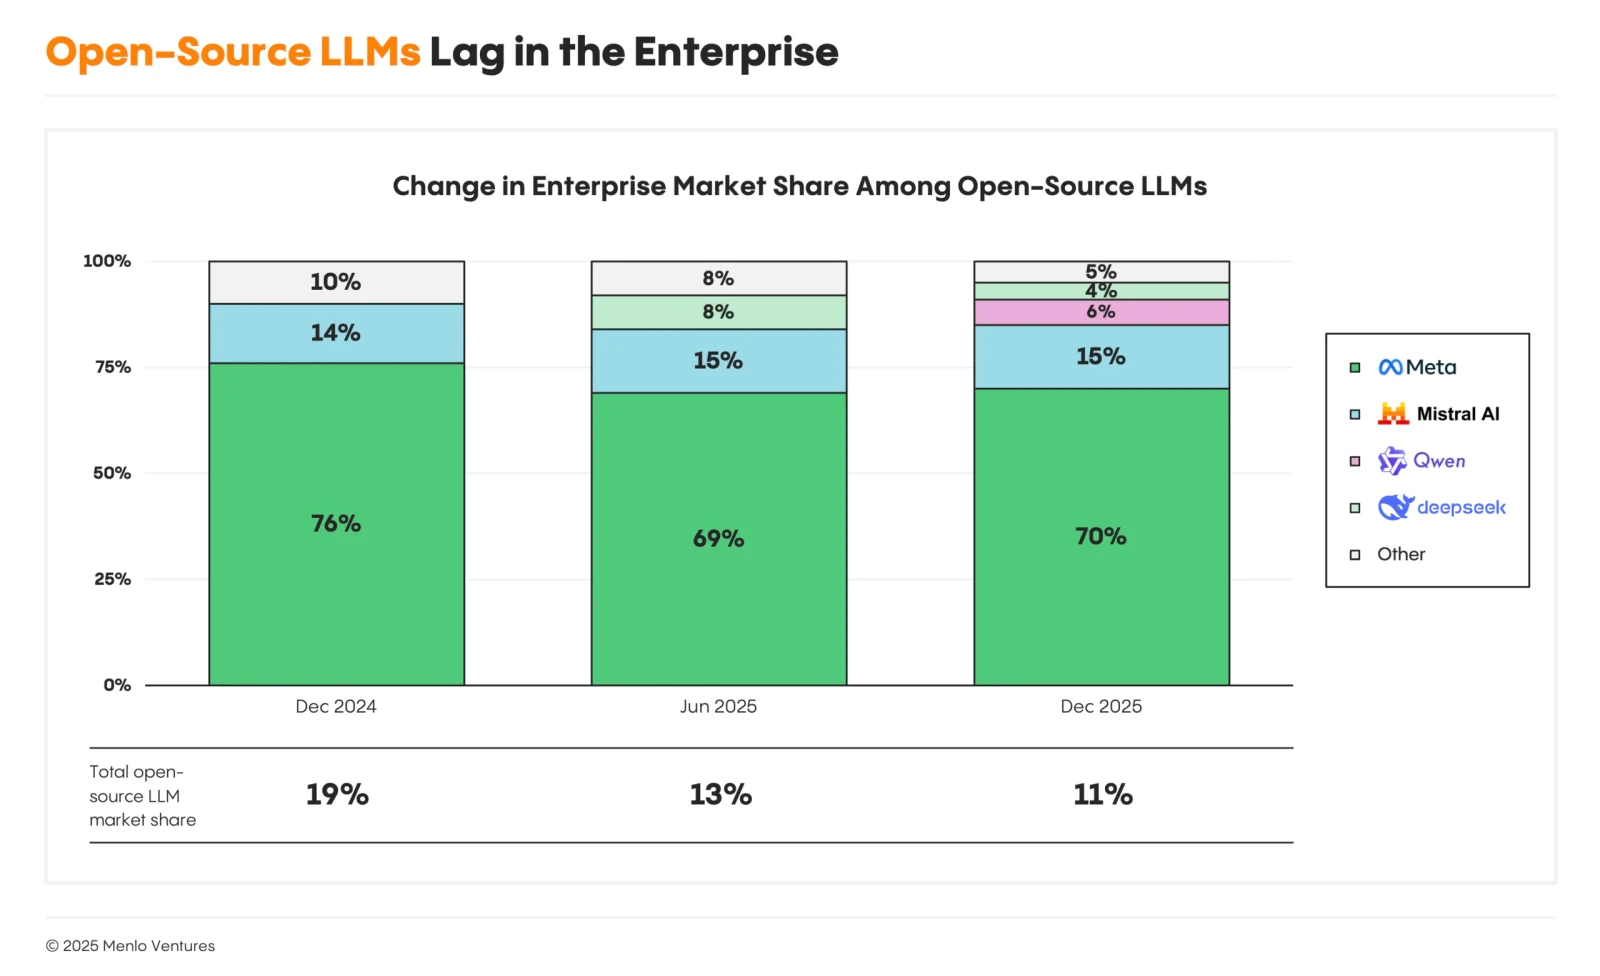
기업 LLM 사용량에서 오픈소스 모델 비중은 2024년 12월 19% 에서 2025년 6월 13%, 2025년 12월 11% 로 줄었습니다. 남은 11% 안에서도 Meta 의 Llama 가 70% 입니다. Qwen·DeepSeek 은 각각 6%·4% 로 성능 대비 채택이 낮은데 보고서는 기업들이 중국계 오픈소스 모델에 특히 신중하다고 적었습니다. 같은 보고서에서 기업 API 점유율은 Anthropic 40%, OpenAI 27%, Google 21% 였습니다.
왜 줄었을까요? 프런티어 모델의 성능이 빠르게 올라가는 동안 오픈 웨이트 모델과의 격차가 기업이 감수할 만큼 좁혀지지 않았습니다. 자체 서빙 인프라를 운영하는 비용이 만만치 않아서입니다. 저도 이 도표를 보기 전까지는 "세계적으로도 오픈소스로 옮겨 가는 중"이라고 막연히 생각했습니다. 2025년까지의 데이터는 반대를 가리킵니다.
두 흐름을 나란히 놓으면 이렇습니다.
| 한국 | 세계 기업 평균 | |
|---|---|---|
| 방향 | sLLM 자체 구축 확산 | 오픈소스 비중 감소(19%→11%) |
| 동력 | 폐쇄망 규제·소버린 AI 사업 | 프런티어 API 성능·운영 편의 |
| 주요 모델 | HyperCLOVA X·EXAONE·A.X·Solar | Llama, Anthropic·OpenAI·Google API |
| 한계 | 성능 격차·GPU·운영 인력 | 데이터 반출·비용·종속 |
즉 "대세"는 조건이 붙은 대세입니다. 데이터를 밖으로 못 보내는 조직에서는 자체 구축이 유일한 길이고 그 제약이 없는 조직은 아직 API 를 고릅니다.
코딩 에이전트에 붙일 수 있는 2026년의 오픈 웨이트 모델
그럼 폐쇄망에서 이 시리즈의 개발 방식을 쓰려면 어떤 모델을 올려야 할까요? 2026년에는 코딩 에이전트용으로 학습된 오픈 웨이트 모델이 실제로 쓸 만한 수준에 왔습니다. 대표가 Alibaba 의 Qwen3-Coder-Next 입니다. 2026년 2월 3일에 Apache 2.0 으로 공개됐고 총 80B 파라미터 중 추론 시 3B 만 활성화되는 MoE 구조입니다. 컨텍스트는 256K 토큰입니다.
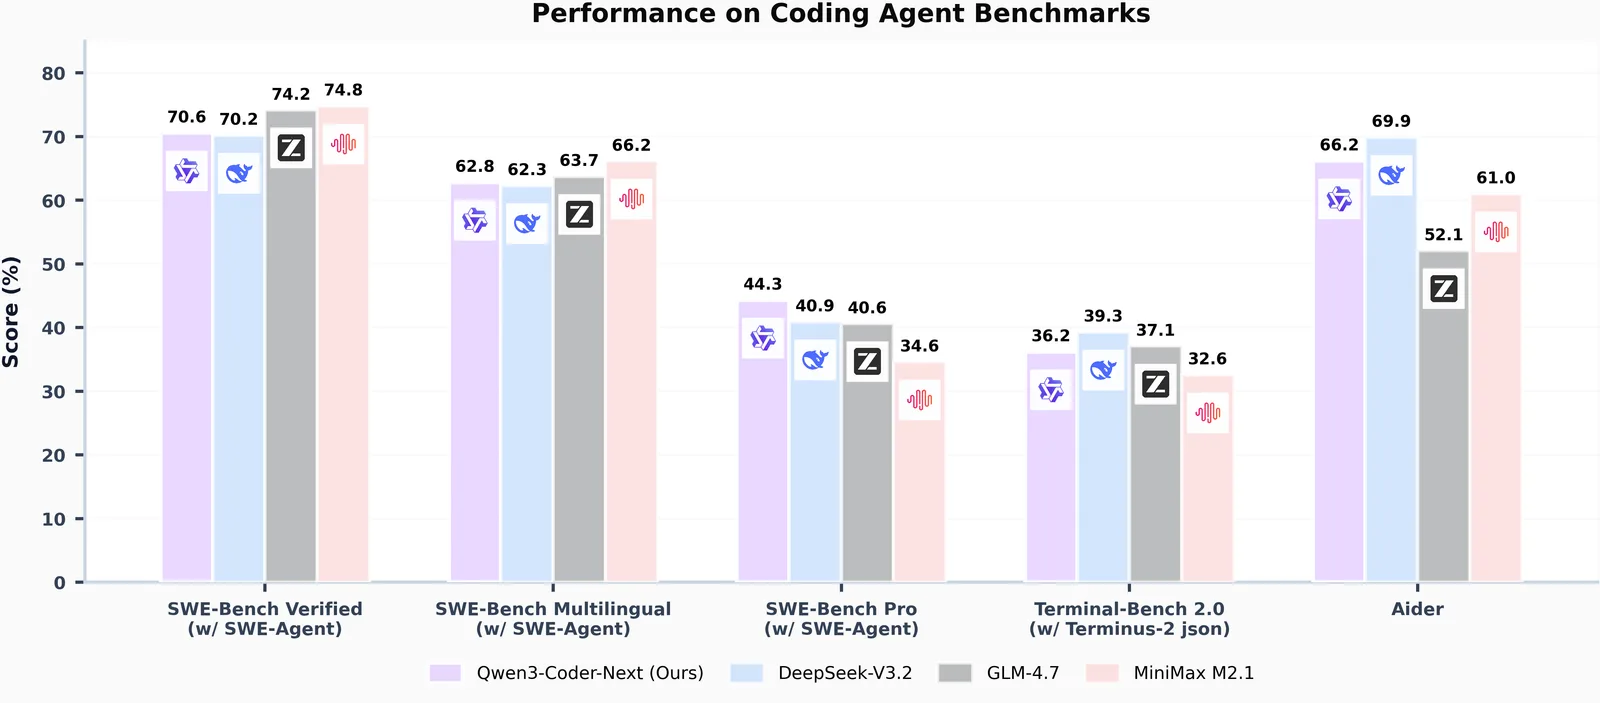
SWE-bench Verified 70.6%, SWE-bench Pro 44.3%, Terminal Bench 2.0 36.2% 입니다. 활성 파라미터가 3B 라 같은 성능대의 다른 모델보다 추론 비용이 훨씬 낮습니다. 모델 카드가 Claude Code·Qwen Code·Cline 같은 CLI·IDE 에 바로 붙는다고 명시합니다. 4비트 양자화로 GPU 한 장에 올려 쓰는 사례가 커뮤니티에 많습니다. 양자화 원리는 양자화 편에 있습니다.
다만 격차는 남아 있습니다. 공개 가중치 상위권이 SWE-bench Verified 70~80%대이고 프런티어 클라우드 모델은 그보다 위입니다. Karpathy 가 2026년 4월 대담에서 말한 "2025년 12월부터 고칠 게 없어졌다"는 경험은 프런티어 모델 이야기입니다. 자체 모델로는 테스트·리뷰 같은 검증 게이트를 더 촘촘히 걸어야 같은 결과가 나옵니다.
실무에서 고르는 기준
정리하면 결정은 모델 성능보다 제약 조건에서 시작합니다.
- 데이터가 밖으로 못 나간다 → 자체 구축 외 선택지가 없다. 코딩용 오픈 웨이트 모델 + 폐쇄망 RAG + 로컬 MCP 서버로 시리즈의 구조를 그대로 옮긴다.
- 비용이 문제다 → 단순·반복 작업은 sLLM, 설계·복잡한 수정은 프런티어 API 로 나누는 하이브리드가 흔한 답이다. 서브에이전트마다 모델을 다르게 지정하면 이 분기를 구현할 수 있다.
- 제약이 없다 → 2026년 기준으로는 프런티어 API 가 여전히 결과가 좋다. Menlo 도표가 그걸 말한다.
어느 쪽이든 승인 게이트·스펙·검증·권한 경계는 그대로 필요합니다. 모델이 바뀌어도 개발 방식은 안 바뀝니다.
모델 위치가 바뀌어도 방식은 같다
sLLM 자체 구축은 한국의 규제 환경과 정부 사업이 만든 실제 흐름입니다. 세계 기업 평균과 다르다는 것도 알고 있어야 합니다. 그리고 어느 모델을 어디에 두든 이 시리즈에서 본 루프·스펙·컨텍스트·검증·보안은 같습니다. 다음 글에서는 이 모든 걸 조직에 도입할 때 무엇이 성패를 가르는지, 개발자는 무엇을 배워야 하는지에 대해서 알아보겠습니다.
참고 자료
- 2025: The State of Generative AI in the Enterprise — Menlo Ventures (2025-12-09) — 오픈소스 점유율 도표 출처
- Qwen/Qwen3-Coder-Next — Hugging Face 모델 카드 — 벤치마크 도표 출처
- 대한민국 '독자 AI 파운데이션 모델' 1차 평가 결과 발표 — 인공지능신문 (2026-01-15)
- 독자 AI 파운데이션 모델 프로젝트, 업스테이지·SK텔레콤·LG AI연구원 3사 다음 단계 진출 — 와우테일 (2026-08-18)
- 미래에셋증권, 네이버클라우드 경량 AI로 온프레미스 기반 sLLM 구축 — 더에이아이