OpenAI 는 엔지니어 7명이 사람 손으로 한 줄도 안 친 100만 줄짜리 제품을 5개월 만에 만들었습니다. 그 바탕이 된 "컨텍스트 수집 → 행동 → 검증" 루프와, 사람이 앞뒤에 붙이는 탐색·계획·리뷰 단계를 Claude Code 문서와 OpenAI·Anthropic 사례로 정리했습니다.
에이전트 한 번의 턴에서 일어나는 일
"버그 고쳐 줘"라고 치고 나면 화면에 파일 읽기, 검색, 명령 실행이 줄줄이 지나갑니다. 저 안에서 정확히 무슨 일이 일어나는 걸까요? Claude Code 공식 문서는 이걸 세 단계로 설명합니다. 컨텍스트 수집(파일 읽기·검색), 행동(편집·명령 실행), 검증(테스트·빌드 결과 읽기). 이 셋을 작업이 끝났다고 판단할 때까지 반복합니다.
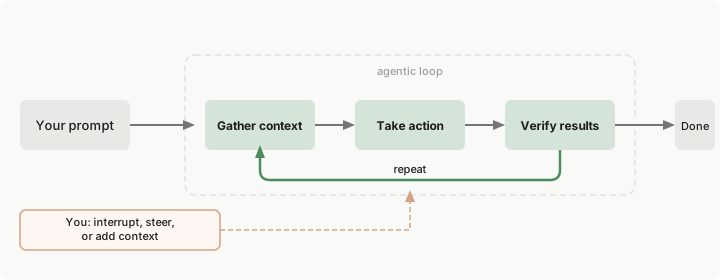
이 루프를 돌리는 부품은 두 개입니다. 추론하는 모델과 행동하는 도구입니다. 모델만 있으면 글만 쓸 수 있습니다. 파일·셸·웹·검색 도구가 붙어야 "에이전트"가 됩니다. 그리고 이 도구와 컨텍스트 관리와 실행 환경을 한데 묶은 껍데기를 하네스라고 부릅니다. Claude Code 도 Codex 도 모델 자체가 아니라 모델을 감싼 하네스입니다.
사람이 붙이는 앞뒤 단계
에이전트가 저 루프를 돈다면 사람은 뭘 할까요? Anthropic 의 Claude Code 모범 사례 문서는 네 단계를 권합니다.
- 탐색 — Plan mode 로 들어가 코드를 읽기만 하게 한다.
- 계획 — 어떤 파일을 어떻게 바꿀지 계획서를 쓰게 하고 사람이 다듬는다.
- 구현 — 계획대로 코드를 쓰고 테스트를 돌리게 한다.
- 커밋 — 메시지를 쓰고 PR 을 열게 한다.
왜 굳이 탐색과 계획을 떼어 놓을까요? 바로 코딩에 들어가면 엉뚱한 문제를 푸는 코드가 나오기 때문입니다. 문서는 단서도 답니다. diff 를 한 문장으로 설명할 수 있는 작은 작업이면 계획 단계를 건너뛰라고 합니다. 오타 수정에 계획서는 과합니다.
저도 처음엔 "계획을 세우게 하면 느려지지 않나" 싶었습니다. 실제로는 반대였습니다. 계획 없이 시작한 세션은 두세 번 고쳐 달라고 하는 사이 컨텍스트가 실패한 시도로 가득 차서 결국 새로 시작하게 됩니다.
검증이 루프를 닫는다
이 루프에서 가장 중요한 칸은 어디일까요? 검증입니다. 모델은 "다 된 것 같다"고 느끼면 멈춥니다. 돌려 볼 테스트가 없으면 "그렇게 보인다"가 유일한 신호이고 실수는 사람이 알아차릴 때까지 기다립니다. 테스트·빌드 종료 코드·린터·스크린샷 비교처럼 통과/실패를 돌려주는 확인 수단을 주면 에이전트가 스스로 돌리고 읽고 고칩니다.
Claude Code 는 이 검증을 얼마나 강하게 걸지도 고르게 합니다. 프롬프트 안에서 "테스트 돌리고 통과할 때까지 고쳐"라고 하는 가벼운 방식부터, /goal 로 세션 내내 조건을 재확인하는 방식, Stop 훅으로 검사 스크립트가 통과하기 전까지 턴을 못 끝내게 막는 방식, 별도 서브에이전트가 결과를 반박하게 하는 방식까지 있습니다. Karpathy 가 2026년 4월 Sequoia 대담에서 한 말, "LLM 은 검증할 수 있는 것을 자동화한다"가 여기서 실체를 갖습니다.
OpenAI 의 하네스 엔지니어링 사례
이 루프로 어디까지 갈 수 있을까요? OpenAI 의 Ryan Lopopolo 가 2026년 2월 11일에 공개한 사례가 답이 됩니다. 엔지니어 7명이 5개월 동안 내부 제품을 만들었는데 사람이 손으로 쓴 코드가 0줄입니다. 코드·테스트·CI·문서 전부 Codex 가 썼습니다. 결과는 약 100만 줄, PR 약 1,500개, 엔지니어 한 명당 하루 PR 3.5개였습니다.
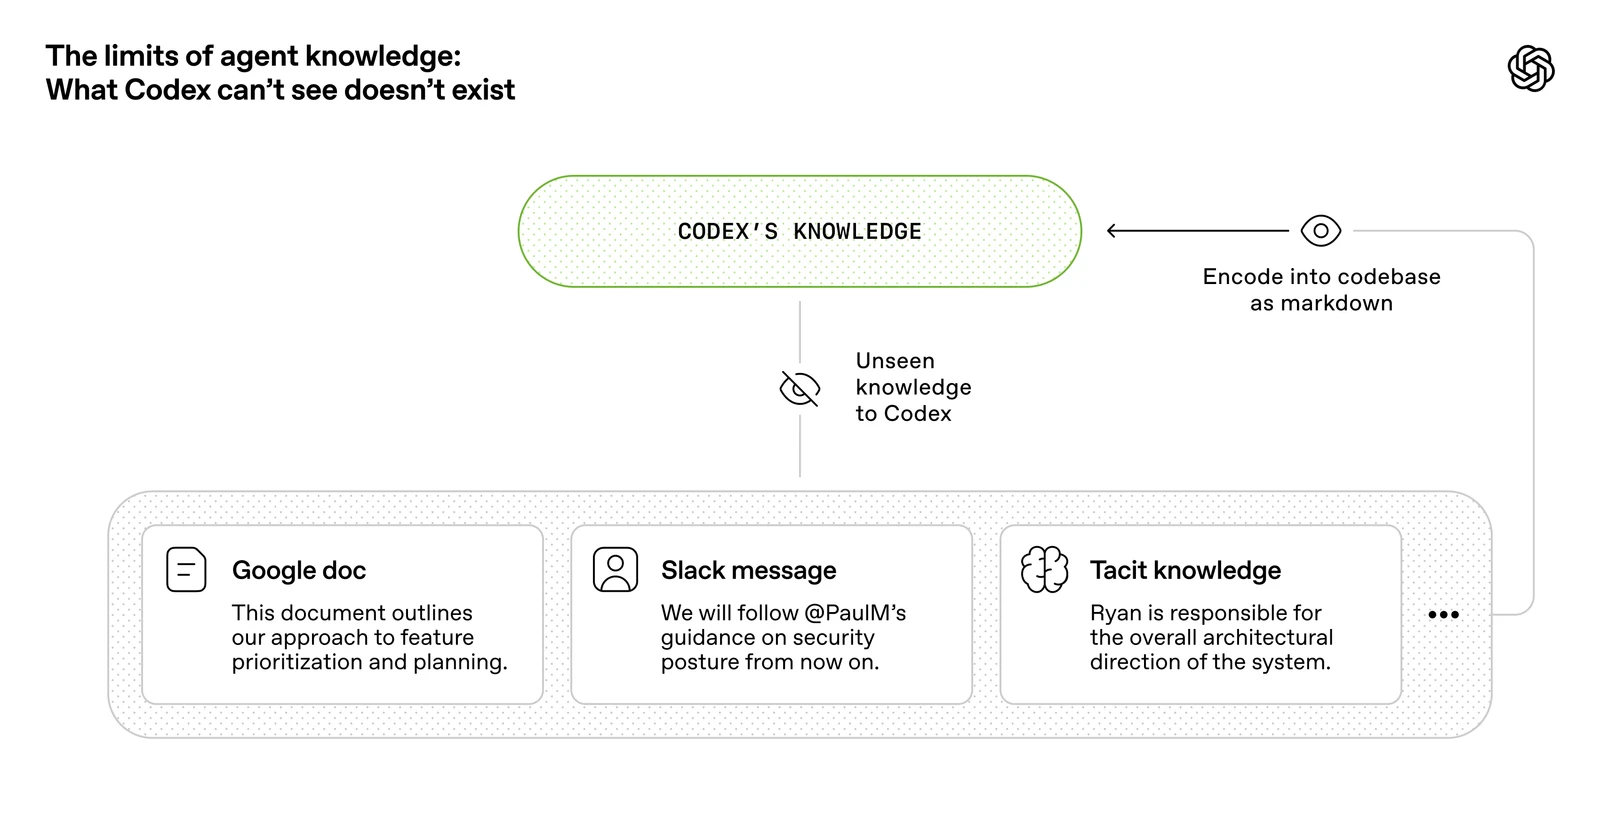
그 팀이 배운 첫 원칙이 위 그림입니다. Google Docs 나 Slack 에 있는 결정, 누군가의 머릿속에 있는 설계 방향은 에이전트에게 존재하지 않는 지식입니다. 그래서 전부 저장소 안 마크다운으로 옮겼습니다. AGENTS.md 는 100줄짜리 목차만 남기고 상세는 docs/ 아래 설계 문서·실행 계획·참고 자료로 나눴습니다.
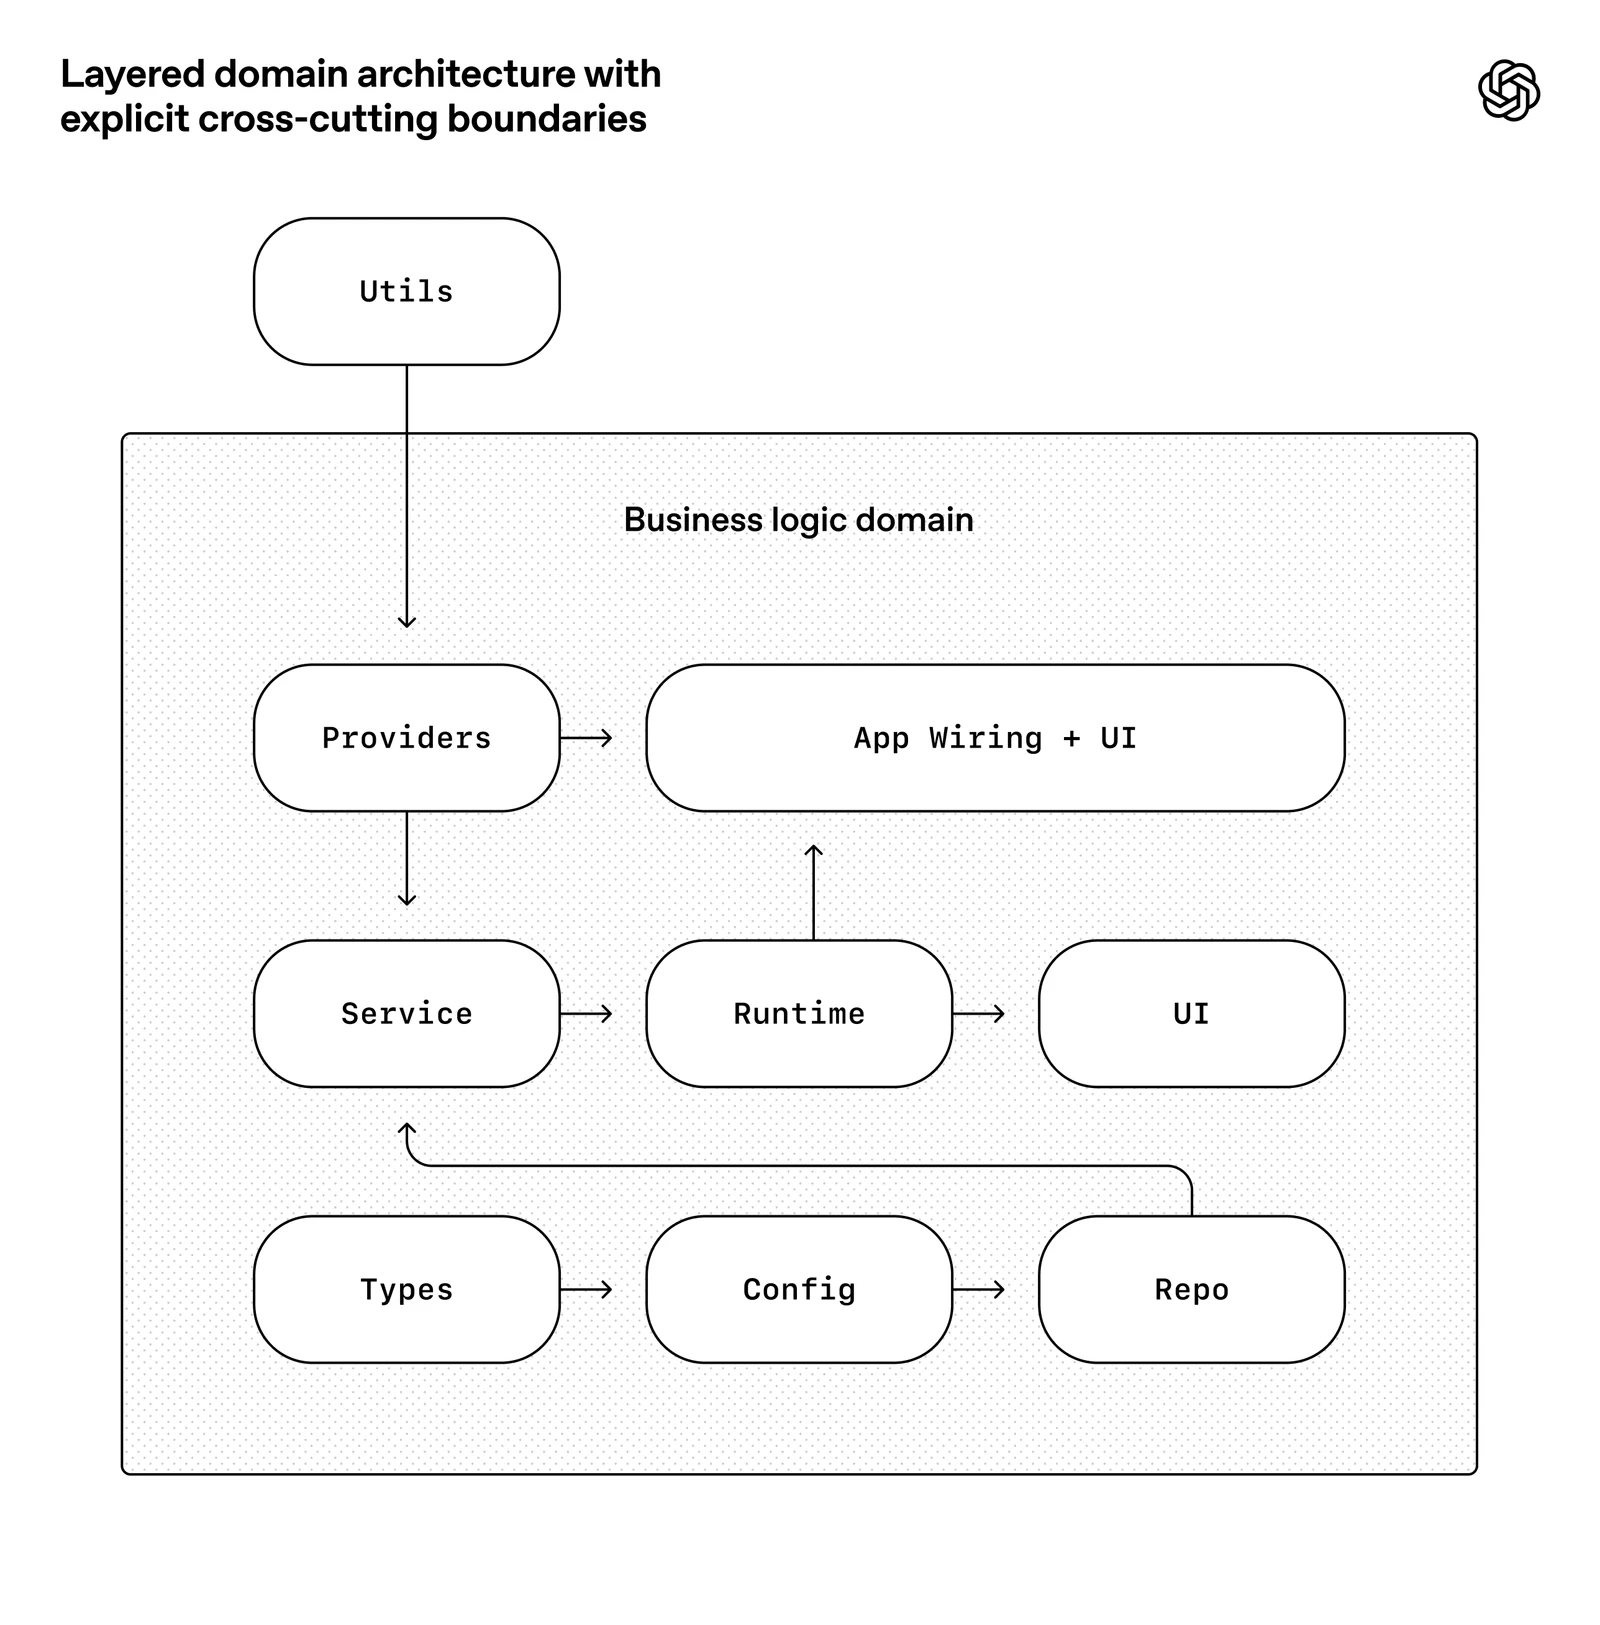
둘째 원칙은 규칙을 문서가 아니라 기계로 강제하는 겁니다. Types → Config → Repo → Service → Runtime → UI 로 층을 나누고 층 사이 의존 방향을 Codex 가 만든 커스텀 린터로 검사했습니다. 에이전트에게 "이 층은 저 층을 부르지 마"라고 문서에 써 두는 것보다 린터가 막는 편이 확실합니다.
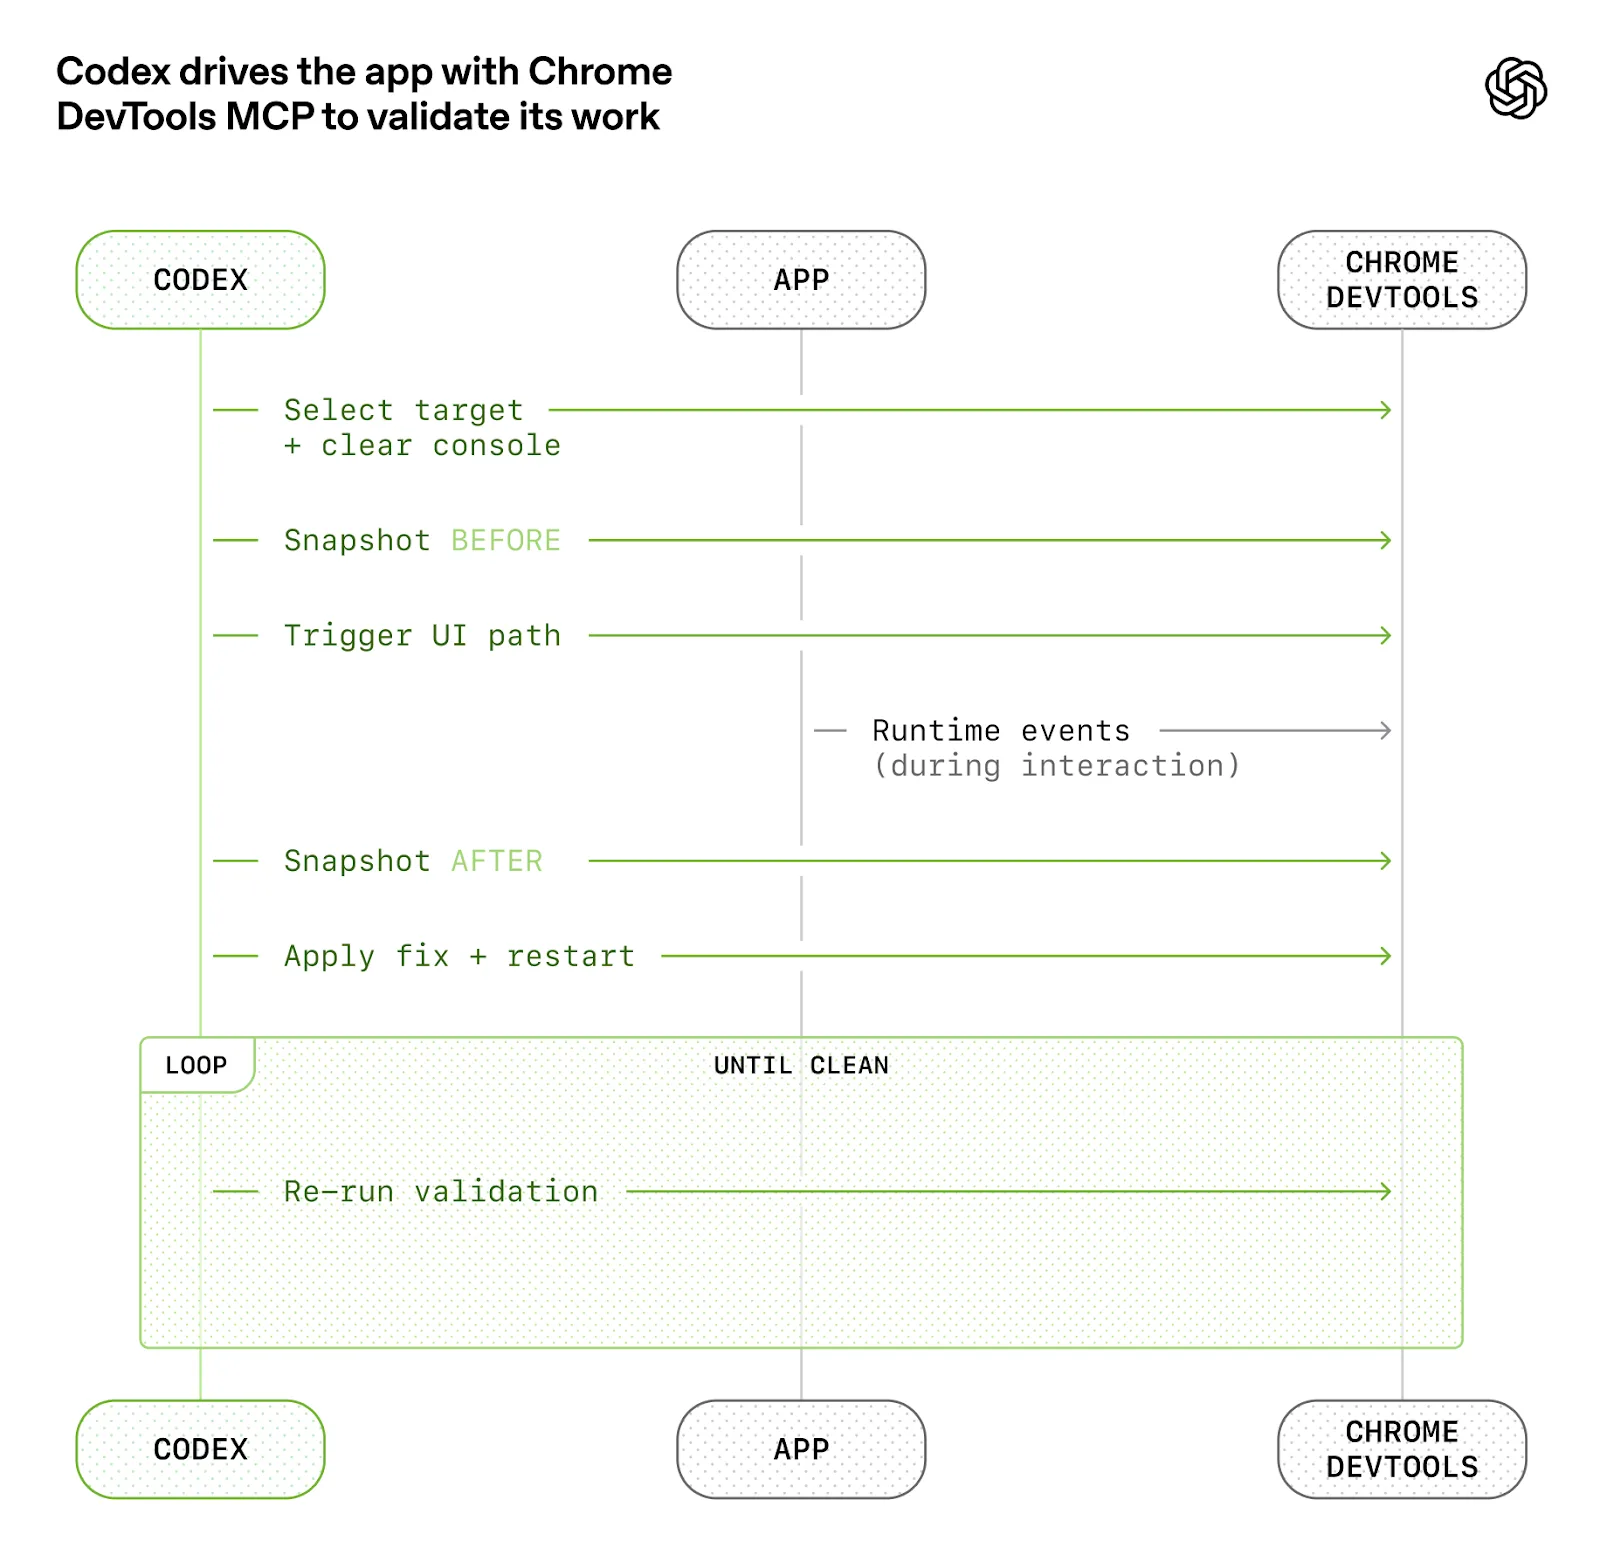
셋째가 검증입니다. Codex 가 Chrome DevTools 를 MCP 로 붙여 화면을 직접 눌러 보고 전후 스냅샷을 비교했습니다. 로그·메트릭·트레이스도 워크트리마다 띄워서 여섯 시간짜리 실행 중에 에이전트가 성능을 스스로 확인하게 했습니다. 이 셋을 합치면 사람은 방향과 승인만 맡게 됩니다.
전체 SDLC 로 넓히면
한 작업의 루프를 봤으니 제품 전체 수명 주기로 넓혀 볼까요? Anthropic 의 부 CISO Jason Clinton 이 2026년 7월 21일에 공개한 자료에 그 그림이 있습니다.
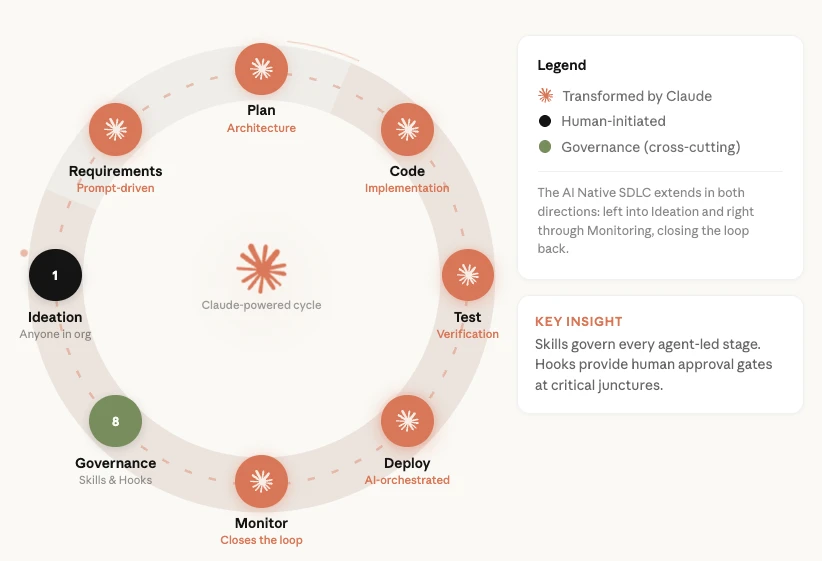
Anthropic 내부에서는 머지되는 코드의 약 80% 를 Claude 가 씁니다. 그림에서 사람이 시작하는 칸은 "아이디어" 하나이고 나머지 요구사항·계획·코드·테스트·배포·모니터링은 에이전트가 주도합니다. 그 위에 걸쳐 있는 거버넌스는 스킬과 훅이 맡습니다. 스킬이 각 단계의 규칙을 알려 주고 훅이 중요한 단계에서 사람 승인을 강제합니다. 스킬과 훅에 대해서는 다른 글에서 따로 알아보겠습니다.
루프 위에 도구를 얹는 순서
여기까지 보면 나머지 도구들의 위치가 정해집니다. 이 루프를 팀의 수명 주기로 넓힌 것이 AI-DLC 같은 방법론입니다. 루프의 입력을 잘 만드는 일이 스펙과 컨텍스트 엔지니어링입니다. 루프가 쓸 도구를 늘리는 일이 MCP 와 스킬입니다. 루프를 닫는 일이 검증·리뷰이고 루프가 넘지 말아야 할 선이 보안입니다. 다음 글에서는 이 루프를 팀 전체로 넓힌 AI-DLC 에 대해서 알아보겠습니다.
참고 자료
- How Claude Code works — Claude Code Docs — 에이전트 루프 도식 출처
- Best practices for Claude Code — Claude Code Docs
- Harness engineering: leveraging Codex in an agent-first world — OpenAI (2026-02-11) — 도식 3장 출처
- How Anthropic secures its AI-native software development lifecycle — Anthropic (2026-07-21) — SDLC 도식 출처