#MIG
1편
AI
기업이 LLM을 여러 GPU에서 서비스하는 방법, Kubernetes·MIG·llm-d
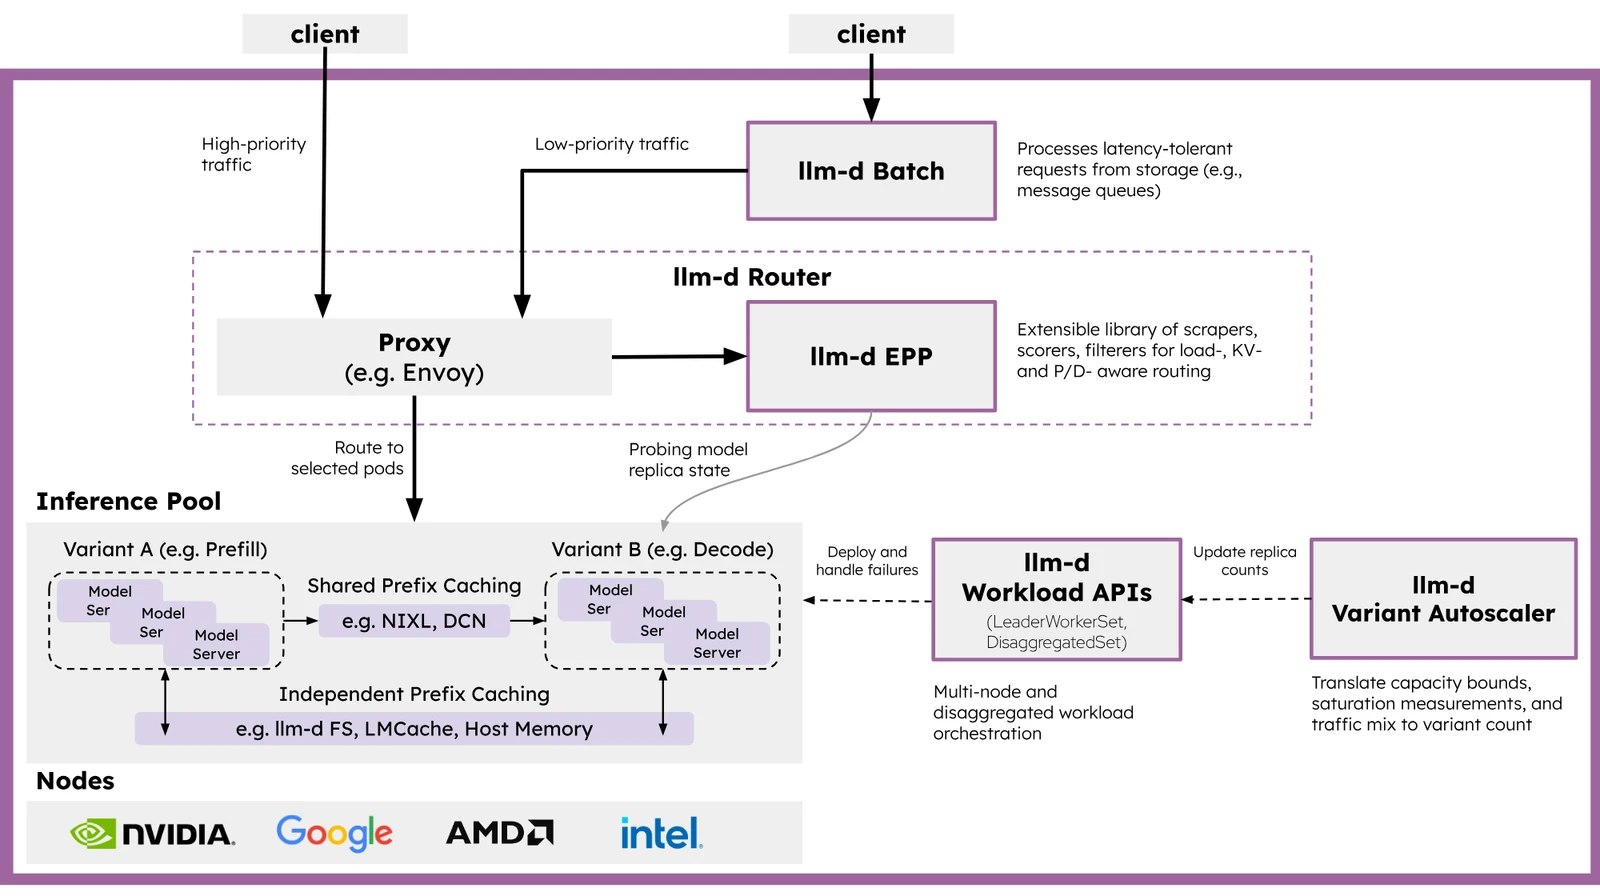
모델이 GPU 한 장에 안 들어가거나, 요청이 서버 한 대를 넘거나, GPU 가 남을 때 기업이 세우는 층 — Tensor Parallel·Kubernetes·MIG·llm-d — 이 각각 무슨 문제를 푸는지 정리했습니다.
1편
모델이 GPU 한 장에 안 들어가거나, 요청이 서버 한 대를 넘거나, GPU 가 남을 때 기업이 세우는 층 — Tensor Parallel·Kubernetes·MIG·llm-d — 이 각각 무슨 문제를 푸는지 정리했습니다.