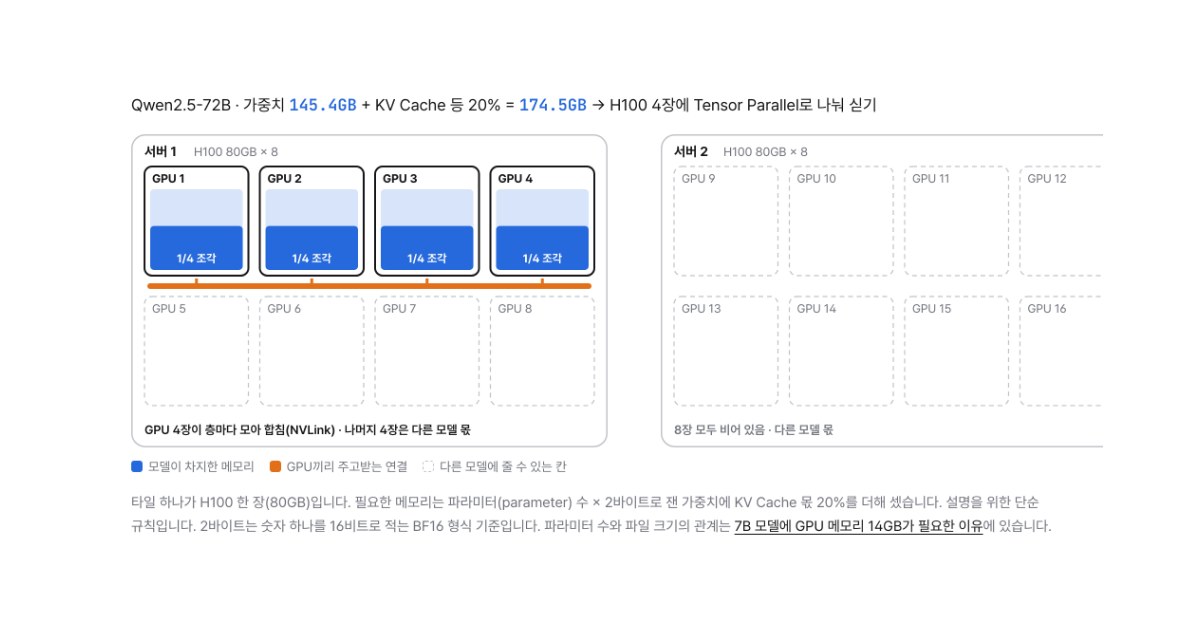
#Tensor Parallel
1편
AI
LLM 하나에 GPU 네 장, GPU 한 장에 LLM 일곱 개
Qwen2.5-72B는 숫자만 145GB라 80GB짜리 H100 한 장에 들어가지 않고, Qwen2.5-3B는 6GB라 한 장을 통째로 주면 대부분이 놉니다. 모델을 GPU 여러 장에 나눠 싣는 Tensor·Pipeline Parallel, 서버 여러 대를 묶는 Kubernetes, GPU 한 장을 칸막이로 나누는 MIG, 캐시를 보고 요청을 보내는 llm-d, 팀마다 서버를 세우지 않는 MaaS까지 직접 조작하는 그림으로 담았습니다.