#LangChain
7편
Agent 루프에 코드를 끼워 넣는 여섯 곳, Middleware
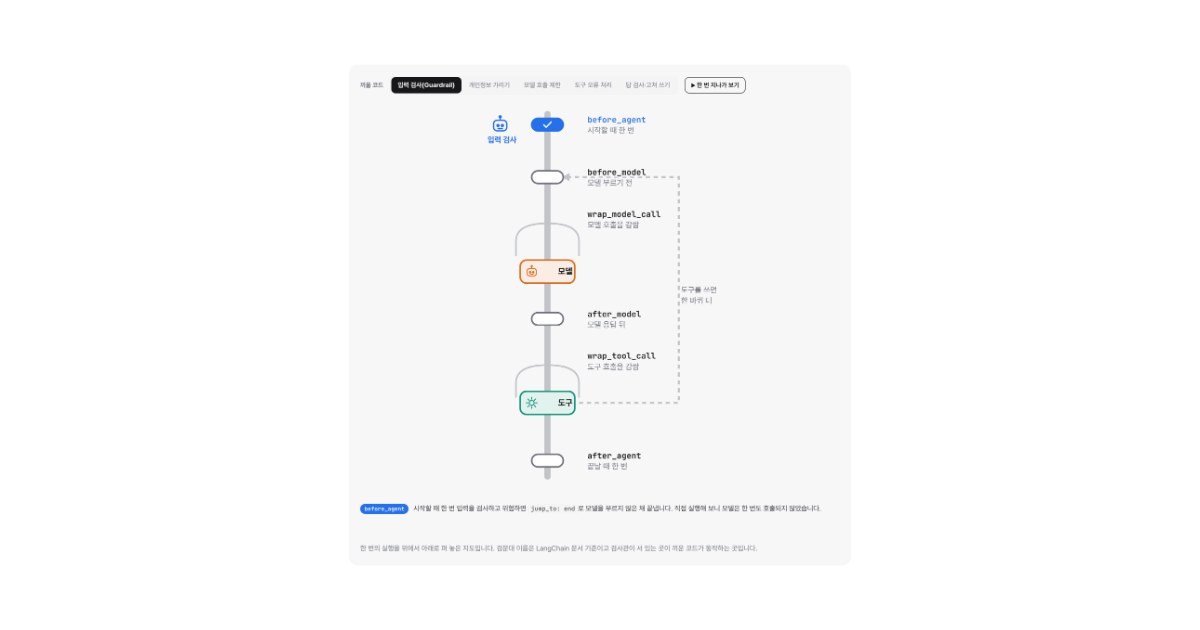
Middleware는 루프를 고치지 않고 모델 호출 앞뒤와 도구 호출 앞뒤에 코드를 끼워 넣는 장치입니다. 훅 여섯 곳의 위치, 훅이 돌아가는 순서, 모델 호출 제한과 개인정보 가리기, 입력을 막는 Guardrail까지 LangChain 1.4를 모의 서버에 붙여 확인한 결과와 함께 그림과 코드로 정리합니다.
직접 짠 루프 24줄은 create_agent 안 어디에 있을까요?
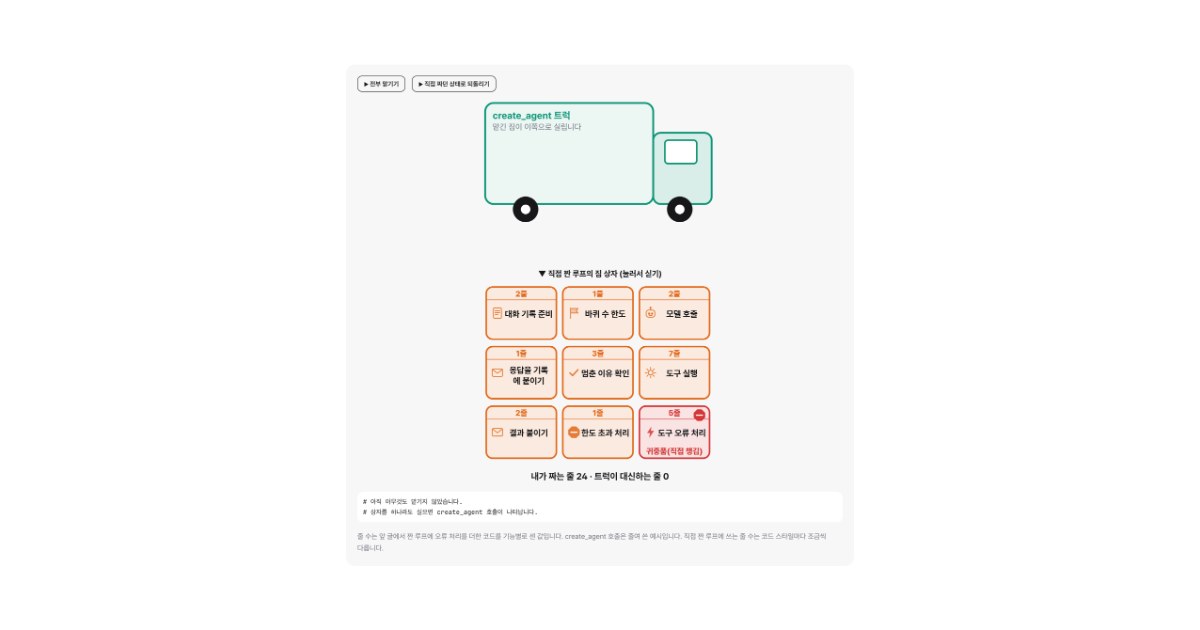
직접 짠 Agent 루프 24줄은 LangChain의 create_agent 호출 하나로 줄어듭니다. 줄마다 어디로 옮겨 갔는지(맡길 수 있는 것과 맡길 수 없는 것), 한 단계씩 지켜보는 stream, 안쪽의 model·tools 그래프, 바퀴 수 한도가 recursion_limit로 바뀐 방식을 그림과 코드로 확인합니다.
모델이 도구를 잘못 고르는 이유는 설명서에 있다
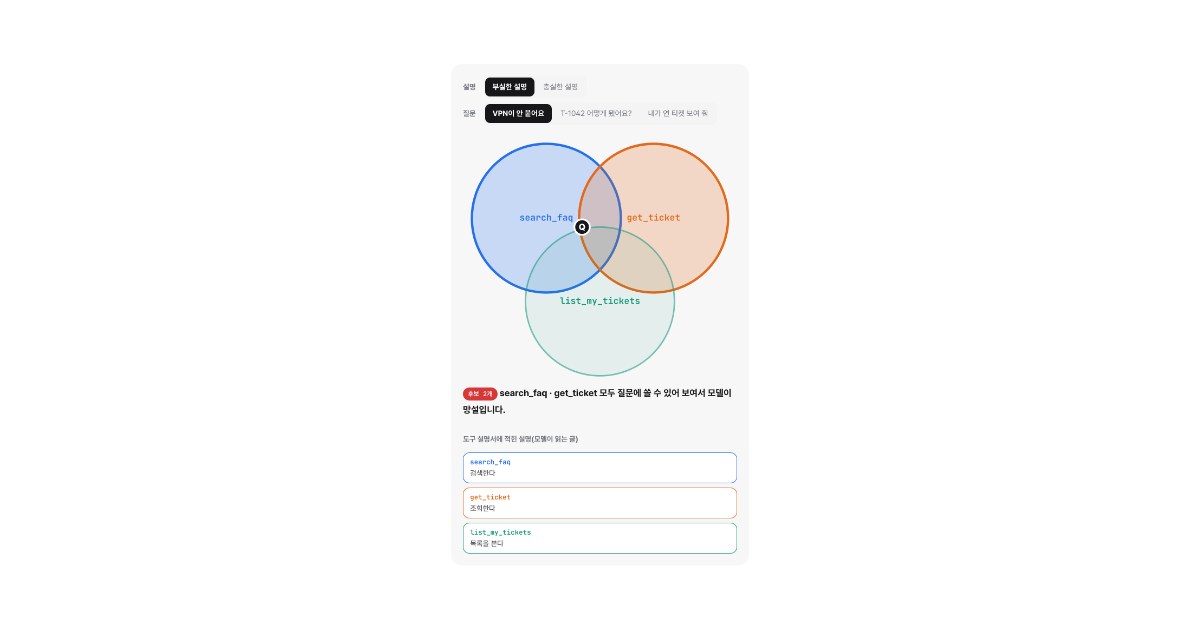
모델은 도구의 함수 코드를 보지 못하고 이름과 설명과 인자 설명만 읽고 고릅니다. LangChain의 @tool로 함수가 설명서로 바뀌는 과정, 설명이 겹치면 왜 헷갈리는지, 반환 크기와 오류 메시지를 어떻게 설계하는지, 모델에게 맡기면 안 되는 사용자 정보를 ToolRuntime으로 받는 법까지 그림과 코드로 확인합니다.
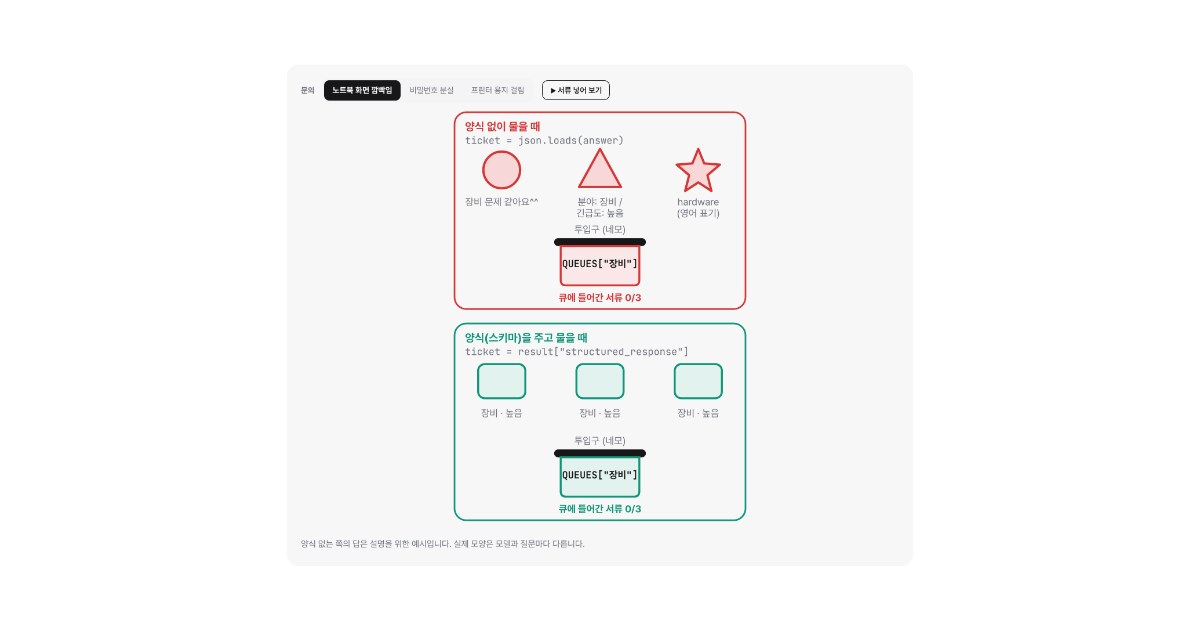
모델 답을 프로그램이 믿고 쓰려면 어떤 양식이 필요할까요?
LLM의 자유로운 글 답은 프로그램이 읽기 어렵습니다. Pydantic 클래스를 양식으로 건네 문의 분류 결과를 항상 같은 모양으로 받는 법을 다룹니다. 양식을 모델에게 넘기는 두 가지 길(ToolStrategy, ProviderStrategy), 모양은 지켜도 범위와 내용은 따로 검사해야 하는 이유, 검증에 실패하면 에러를 모델에게 돌려 다시 시키는 재시도까지 그림과 코드로 확인합니다.
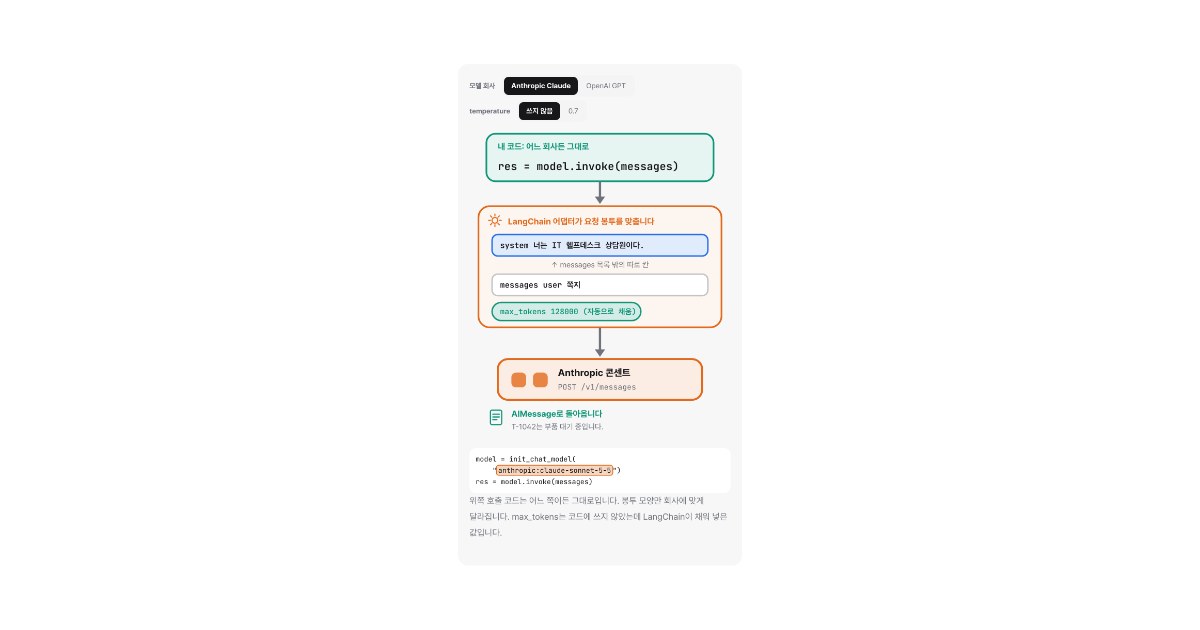
GPT를 Claude로 바꾸는 데 필요한 코드 한 줄, LangChain 첫걸음
LangChain의 init_chat_model은 "anthropic:claude-sonnet-5-5" 같은 문자열 하나로 모델 회사를 바꿔 줍니다. 호출 코드는 그대로인데 실제 요청 봉투 모양이 어떻게 달라지는지, 서랍장에서 클래스가 골라지는 과정, 메시지 네 종류와 AIMessage 안에서 같은 것과 다른 것, invoke·stream·batch의 차이, 그리고 문자열만 바꿔서는 안 되는 경우(temperature)까지 그림과 코드로 확인합니다.
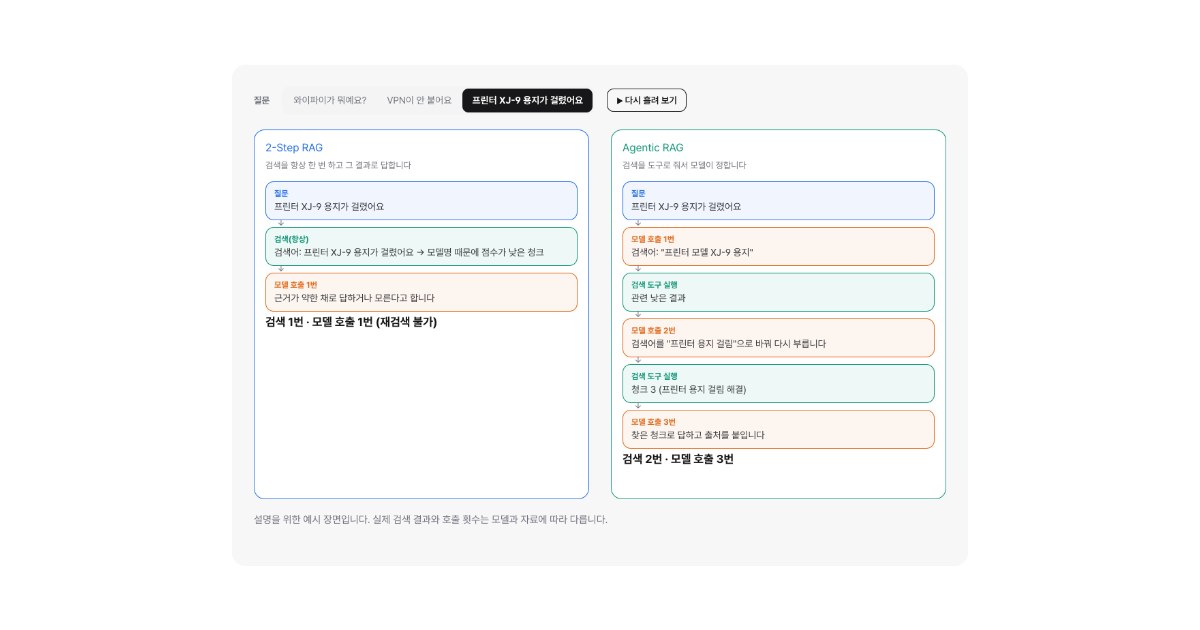
검색을 도구로 바꾸면 달라지는 것, Agentic RAG
RAG에서 검색을 항상 한 번 하는 방식(2-Step)과 검색을 도구로 줘서 Agent가 횟수와 검색어를 정하는 방식(Agentic RAG)을 같은 질문으로 비교합니다. 매뉴얼을 청크로 나눠 저장하고 검색 도구로 감싸는 코드, 출처를 artifact로 따로 보관하는 법, 검색이 비거나 빗나갈 때의 재검색과 한도까지 LangChain 1.4를 모의 서버에 붙여 확인한 결과와 함께 정리합니다.
책상 위와 서랍 속, Agent의 단기 기억과 장기 기억
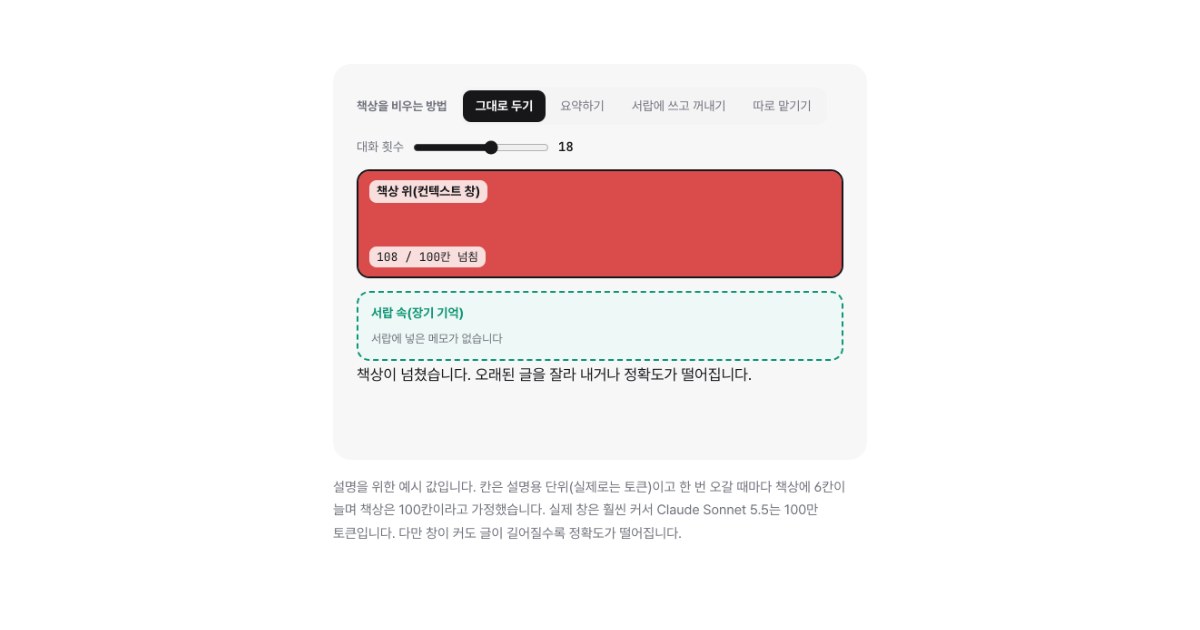
Agent는 호출이 끝나면 아무것도 기억하지 못하고 대화가 길어지면 컨텍스트 창이 차서 정확도가 떨어집니다. thread_id와 checkpointer로 대화를 이어 가는 단기 기억, Store로 사용자 정보를 서랍에 넣어 두는 장기 기억, 요약으로 책상을 비우는 SummarizationMiddleware, Context Engineering의 네 전략(write·select·compress·isolate)을 그림과 코드로 확인합니다.