#LLM-as-judge
1편
AI
Agent가 잘한다는 것을 어떻게 숫자로 보일 수 있을까요?
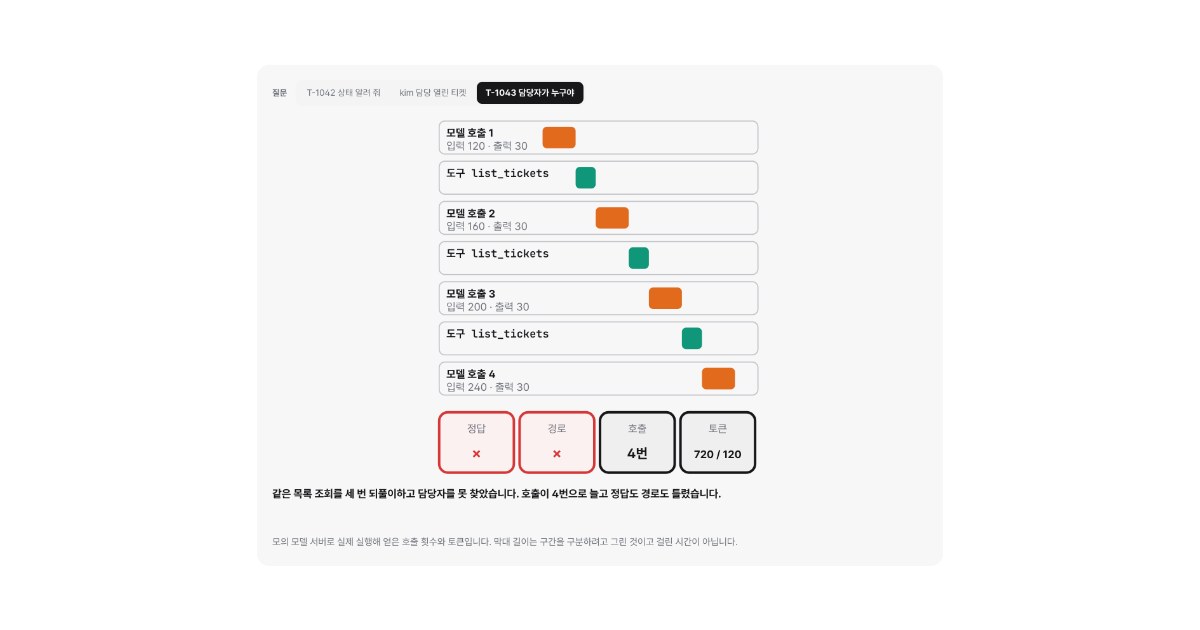
Agent의 실행 한 번을 모델 호출과 도구 호출의 나무(trace)로 기록하고 질문과 기대 답과 기대 경로를 담은 데이터셋으로 최종 답과 경로와 심판 모델(LLM-as-judge)이 매긴 점수를 냅니다. 진짜 도구 대신 모델이 흉내 내는 LLMToolEmulator로 시험하는 방법과 호출 수·토큰으로 비용을 보는 법을 langchain 1.4로 직접 실행해 확인한 결과와 함께 정리합니다.