#PagedAttention
1편
AI
vLLM이 같은 GPU로 요청을 몇 배 더 받는 이유
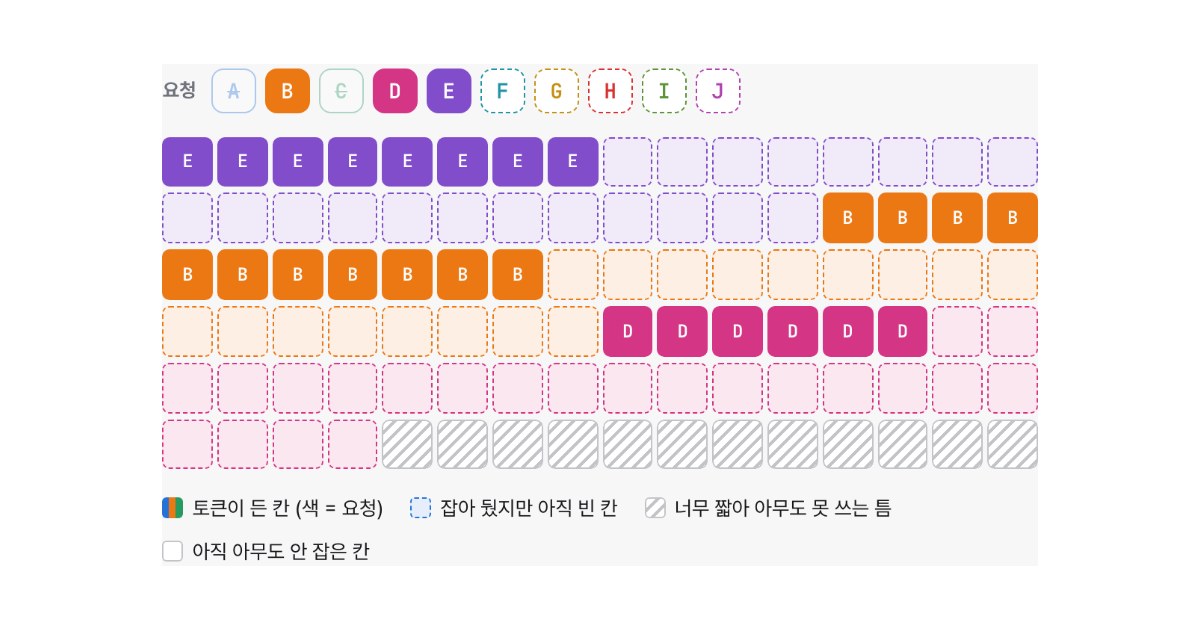
예전 LLM 서버는 KV Cache 자리를 요청마다 최대 길이만큼 미리 잡아서 잡은 자리의 20~38%에만 실제 토큰이 들어 있었습니다. 같은 GPU 메모리에 요청을 몇 명이나 태울 수 있는지 좌석표로 직접 돌려 보며 PagedAttention의 블록 테이블, 끝난 자리에 바로 다음 요청을 넣는 Continuous Batching, vllm serve 한 줄까지 정리했습니다.