Agent의 while 루프는 무엇이 멈추게 할까요?
시험 전날 조사 숙제를 한다고 해 봅니다. 책을 찾아 읽고 메모한 뒤 부족하면 다른 책을 찾습니다. 충분해지면 제출하고 시간이 다 되면 거기서 멈춥니다.
Agent 프로그램도 같은 일을 합니다. 모델을 부르고 도구(모델이 직접 못 하는 일을 대신 해 주는 우리 쪽 함수)를 실행하고 결과를 넣어 다시 모델을 부르는 과정을 되풀이합니다. 이 되풀이를 루프(loop)라고 부릅니다. 이 루프는 언제 어떻게 끝날까요?
아래 트랙에서 주황 택배 상자(모델과 주고받는 messages 묶음)가 루프를 한 바퀴씩 돕니다. 모델이 답을 다 쓰면 오른쪽 길로 빠져나가 끝나고 한도에 걸리면 길이 막힙니다. 상황과 한도를 바꿔 돌려 보세요.
처음 질문모델 응답도구 결과오류 결과
택배 상자가 루프 한 바퀴를 돕니다. 바퀴 수와 상황은 설명을 위한 예시입니다. messages 더미는 한 바퀴에 두 장(모델 응답, 도구 결과)씩 쌓입니다.
질문마다 모델과 도구가 주고받는 횟수가 다릅니다
헬프데스크 Agent에게 질문 네 개를 합니다. 와이파이를 끄고 켜는 법은 도구 없이 한 번에 답합니다. 티켓 상태는 조회를 한 번 하니 모델을 두 번 부릅니다. 티켓 상태와 해결 방법을 함께 물으면 조회와 FAQ 검색을 거쳐 세 번 부릅니다. 마지막 질문은 모델이 같은 도구만 계속 부르는 경우입니다.
탁구 랠리와 비슷합니다. 모델이 공(도구 요청서)을 치면 코드가 받아 쳐 주고(결과) 모델이 다시 칩니다. 몇 번 오갈지는 시작할 때 모릅니다. 사람은 충분하다 싶으면 스스로 그만두지만 모델은 같은 검색을 되풀이할 수도 있어서 코드가 한도를 둬야 합니다.
설명을 위한 예시 장면입니다. 파란 화살표는 모델이 쓴 도구 요청서, 초록 화살표는 코드가 돌려준 도구 결과이고 깃발은 모델이 답을 다 쓴 때입니다.
루프 한 바퀴는 messages에 카드 두 장을 쌓습니다
모델은 앞선 호출을 기억하지 못합니다. 호출마다 처음부터 새로 읽는 계산이라서 앞 내용을 알려면 매 바퀴 messages(대화 기록 목록) 전체를 다시 보내야 합니다. 그림에서 카드가 쌓이는 순서를 보세요.
모델 응답이 카드 한 장(assistant)이 되고 도구 결과가 카드 한 장(user)이 되니 한 바퀴에 두 장이 쌓입니다. 마지막 바퀴만 도구 결과 없이 답 카드 한 장으로 끝납니다.
시작: 질문 한 장
messages에는 사용자의 질문 카드 한 장뿐입니다. 모델을 부르기 전 상태입니다.
1번째 호출
카드 한 장을 보내자 모델이 티켓 조회 요청서를 씁니다. 모델은 요청서만 쓸 뿐 실행은 코드가 합니다. 이 응답이 assistant 카드로 붙고 stop_reason은 tool_use입니다.
코드가 도구를 실행
코드가 get_ticket을 실행하고 결과를 user 카드로 붙입니다. 요청서의 번호(toolu_01A)가 결과 카드에도 적혀 둘이 짝이 됩니다.
2번째 호출
카드 세 장을 모두 보냅니다. 모델은 조회 결과를 읽고 이번에는 FAQ 검색 요청서를 씁니다.
다시 도구를 실행
FAQ 검색 결과가 user 카드로 붙습니다. 카드는 다섯 장이 됩니다.
3번째 호출
카드 다섯 장을 보내자 모델이 도구 없이 글로 답합니다. stop_reason이 end_turn이라 루프가 끝납니다.
# ... import, client, MODEL, tools, run_tool 은 아래에서 본다
def run_agent(question, max_turns=8):
    # 1 대화 기록: 질문 한 장으로 시작
    messages = [{"role": "user", "content": question}]
    # 2 바퀴 수에 한도를 둔다
    for turn in range(max_turns):
        # 3 모델 호출 한 번
        res = client.messages.create(
            model=MODEL, max_tokens=1024, tools=tools, messages=messages)
        # 4 응답을 기록에 붙이고 멈춘 이유를 찍는다
        messages.append({"role": "assistant", "content": res.content})
        print(f"{turn + 1}번째 호출: {res.stop_reason}")
        # 5 도구 요청이 아니면 끝난다
        if res.stop_reason != "tool_use":
return "".join(b.text for b in res.content if b.type == "text")- 대화 기록입니다. messages는 역할(
role)과 내용(content)을 이름표로 단 묶음(Python에서는 딕셔너리라고 부릅니다)을 순서대로 담은 목록입니다. 처음에는 사용자 질문 한 장뿐입니다. - 바퀴 수 한도입니다.
while True대신for turn in range(max_turns)를 쓰면 최대 8번만 돌고 반드시 끝납니다. 한도를 빼면 모델이 도구를 계속 부르는 한 루프도 끝나지 않습니다. - 모델 호출입니다.
max_tokens는 이번 답의 길이 한도이며 토큰(모델이 글을 읽고 쓰는 단위) 수로 셉니다. Anthropic API에서는 꼭 넣어야 하는 값입니다. - 응답 기록입니다.
res.content는 글 조각과 도구 요청 조각이 섞인 목록입니다. 도구 요청 조각의 번호가 남도록 그대로 붙여야 결과 카드와 짝을 맞출 수 있습니다. - 끝내는 조건입니다. 도구 요청으로 멈춘 게 아니면 글 조각만 이어 붙여 돌려주고 끝냅니다. 가장 단순한 종료 조건입니다.
        # 6 요청서마다 도구를 실행한다
        results = []
        for block in res.content:
            if block.type != "tool_use":
                continue
            out = run_tool(block.name, block.input)
            results.append({"type": "tool_result",
                            "tool_use_id": block.id, "content": out})
        # 7 결과를 user 카드 한 장에 담아 붙인다
        messages.append({"role": "user", "content": results})
return f"{max_turns}번 안에 끝내지 못했습니다."출력은 예시 답입니다. 코드는 anthropic 패키지 1.15, 모델은 claude-sonnet-5-5 기준입니다.
- 요청서마다 도구를 실행합니다. 한 응답에 도구 요청이 여러 개 올 수 있어 조각을 하나씩 돌며 글 조각은 건너뜁니다.
block.input은 이미 딕셔너리입니다. - 결과를 카드 한 장에 모읍니다. 요청서가 둘이면 결과 둘을 같은 user 카드에 담고 결과마다
tool_use_id로 짝을 적습니다. 하나라도 빠지면 API가 요청을 거절합니다(요청 형식이 틀렸다는 400 오류).
stop_reason이 루프의 갈림길입니다
모델의 응답에는 멈춘 이유를 적은 stop_reason이 붙습니다. 코드는 이 값을 보고 다음에 할 일을 정합니다. 기차가 분기기에서 길을 고르는 것과 같습니다. 루프를 계속 돌리는 길은 tool_use 하나입니다.
나머지는 모두 루프를 나가는 길인데 끝나는 모습이 다릅니다. end_turn(모델이 할 말을 다 하고 스스로 멈춘 경우)만 정상 종료입니다. 잘림이나 거절을 정상 종료처럼 다루면 도중에 끊긴 글을 완성된 답으로 착각합니다. 길을 눌러 기차를 보내 보세요.
응답 모양은 설명을 위해 줄인 예시입니다. max_tokens는 모델이 한 번에 쓸 수 있는 답의 길이 한도이고 앞에서 본 바퀴 수 한도(max_turns)와는 다른 한도입니다.
그 밖의 stop_reason 값
pause_turn은 웹 검색 같은 서버 도구가 한 번에 끝나지 않아 멈췄다는 뜻으로, 응답을 그대로 messages에 붙여 다시 부르면 이어서 진행합니다. stop_sequence는 우리가 정해 둔 끊는 글자가 나왔다는 뜻이고 model_context_window_exceeded는 모델이 한 번에 볼 수 있는 길이를 다 채웠다는 뜻입니다. 이 글의 도구는 우리 코드가 실행하는 도구라서 이 값들은 나오지 않거나 드뭅니다.
# 8 멈춘 이유를 값마다 나눈다
reason = res.stop_reason
if reason == "end_turn":
    return text_of(res)  # 글 블록만 이어 붙이는 도우미 함수
elif reason == "max_tokens":
    return "답이 길이 한도에서 잘렸습니다."
elif reason == "refusal":
    return "모델이 이 요청에 답하지 않았습니다."
elif reason != "tool_use":
    return f"처리하지 못했습니다 ({reason})"
# tool_use 이면 아래에서 도구를 실행한다- 값마다 길을 나눕니다. 코드 ⑤번 주석 줄의 한 줄 조건을 값별로 쪼갠 것입니다.
end_turn에서만 답을 돌려주고max_tokens와refusal은 사용자에게 상황을 알리고 끝냅니다. 마지막elif는 처음 보는 값을 잡는 안전장치입니다.
바퀴 수 한도가 없으면 비용이 가파르게 쌓입니다
모델이 같은 도구만 계속 부르거나 오류를 되풀이하면 루프는 스스로 끝나지 않습니다. 매 바퀴 messages 전체를 다시 보내니 바퀴가 늘수록 한 번에 보내는 양도 늘어납니다. 그래서 합계는 바퀴마다 짐이 쌓이듯 가파른 곡선으로 치솟습니다.
Anthropic의 에이전트 글도 최대 반복 횟수 같은 종료 조건을 두라고 권합니다. 몇 바퀴가 적당한지는 정해진 값이 없어서 평소 바퀴 수를 재어 여유 있게 잡습니다.
설명을 위한 예시 값입니다. 첫 호출에 1,500토큰(지시문·도구 설명·질문)을 보내고 바퀴마다 500토큰(응답과 도구 결과)이 쌓인다고 가정했습니다. 세로축은 지금까지 보낸 토큰 합계입니다. 실선은 실제로 보낸 구간이고 점선은 한도가 없었다면 이어졌을 구간입니다.
출력은 예시입니다. 호출을 run_agent(question, max_turns=3)으로 바꿔 실행한 결과를 가정했습니다.
한도에 걸려 for 문이 끝나면 마지막 return이 실행됩니다. 이 문장을 정상 답처럼 사용자에게 보여 주지 않도록 호출하는 쪽에서 따로 구분하는 편이 안전합니다.
도구가 실패하면 예외 대신 결과로 돌려줍니다
모델이 인자를 잘못 쓰는 일이 가끔 있습니다. 예를 들어 T-1042 대신 T1042라고 쓰면 티켓 조회가 실패합니다. 이 예외(프로그램이 실행 중에 만난 오류 신호)를 그대로 터뜨리면 프로그램이 멈추고 사용자는 답을 받지 못합니다.
Anthropic 문서는 실패를 tool_result의 is_error: true(이 결과는 실패라는 표시)로 돌려주라고 안내합니다. 모델은 오류 문장을 읽고 인자를 고쳐 다시 부릅니다. 오류 문장에는 무엇이 틀렸는지와 어떻게 고치면 되는지를 적어야 합니다. "실패"라고만 적으면 고칠 단서가 없습니다.
설명을 위한 예시 장면입니다. 두 쪽 모두 모델이 처음에 같은 실수를 합니다. 위쪽은 도구 안의 예외가 밖으로 나가 길이 끊기고 아래쪽은 오류가 편지(tool_result)로 돌아가 모델이 고칩니다.
def run_tool(name, args):
    if name == "get_ticket":
        # 9 무엇이 틀렸고 어떻게 고칠지 적는다
        ticket = TICKETS.get(args["ticket_id"])
        if ticket is None:
            raise ValueError(f"{args['ticket_id']} 티켓이 없습니다. 번호는 T-1042 같은 형식입니다.")
        return str(ticket)
    # ...

# 루프 안에서 run_tool 을 부르는 부분
            try:
                out, is_error = run_tool(block.name, block.input), False
            except Exception as e:
                # 10 예외를 결과로 바꿔 돌려준다
                out, is_error = str(e), True
            results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})출력은 예시입니다. 오류 줄은 코드에 넣은 print 때문에 보입니다.
- 오류 문장도 모델이 읽는 글입니다. 틀린 값(
T1042)과 맞는 형식(T-1042)을 함께 적으면 모델이 다음 호출에서 고칠 수 있습니다. 문장이 막연하면 같은 실수를 되풀이하다 바퀴 수 한도에 걸립니다. - 예외를 결과로 바꿉니다.
is_error를True로 두면 모델이 이 결과를 실패로 읽습니다. 그래도 같은 실수가 계속되면 마지막에는 바퀴 수 한도가 루프를 끊습니다.
도구 요청이 둘이면 결과도 번호를 맞춰 한 장에 담습니다
모델은 한 응답에 도구 요청을 여러 개 쓸 수 있습니다. 티켓 조회와 FAQ 검색을 한꺼번에 시키는 식입니다. 요청마다 번호(tool_use_id)가 붙고 결과 카드에는 같은 번호를 적어 짝을 맞춥니다.
결과는 요청 수만큼 한 장의 user 카드에 모아 돌려줍니다. 하나라도 빠지면 API가 요청을 거절합니다. 그림에서 결과를 한 장에 담을 때와 한 개만 돌려줄 때를 비교해 보세요.
색이 같은 선이 같은 번호의 요청과 결과입니다. 오류 문구는 Anthropic 문서의 설명을 줄여 옮긴 것입니다.
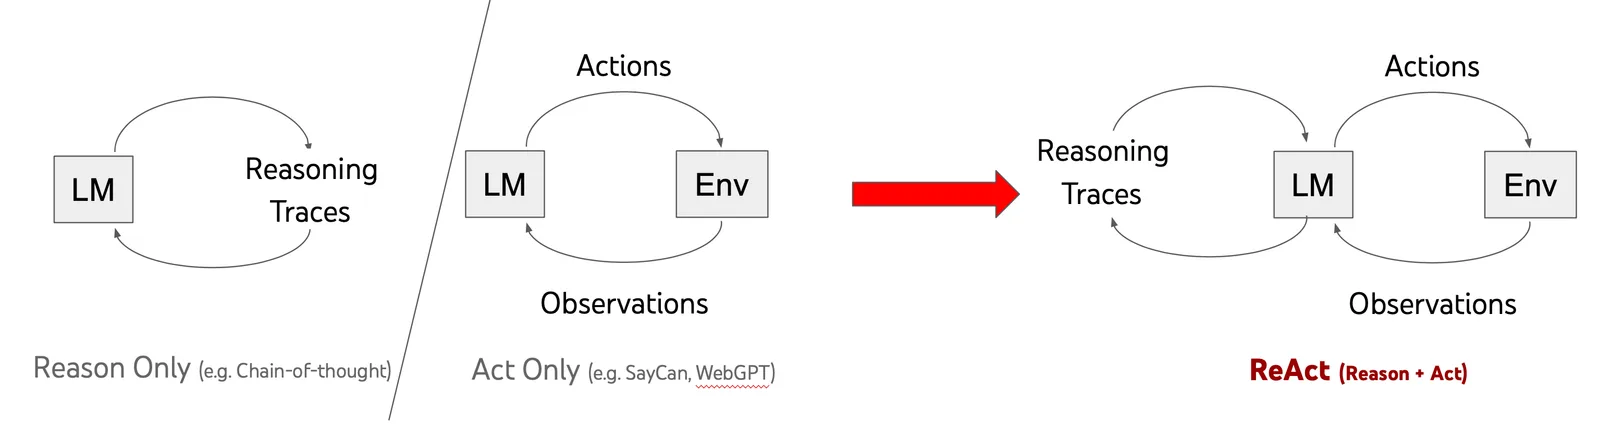
ReAct의 생각·행동·관찰과 API 블록은 닮았습니다
ReAct는 Shunyu Yao 등이 2022년 10월에 arXiv에 올린 논문 「ReAct: Synergizing Reasoning and Acting in Language Models」에서 나온 방식입니다. 모델이 생각(Thought)을 쓰고 행동(Action)을 하고 관찰(Observation) 결과를 받는 과정을 되풀이합니다.
지금 API에서는 행동이 tool_use 블록으로, 관찰이 tool_result로 구조화돼 옵니다. 생각은 모델이 도구를 부르기 전에 글 블록을 함께 쓸 때만 보입니다. 이 대응은 논문과 문서를 맞춰 본 필자의 해석입니다. 그림처럼 생각과 행동은 모델이 쓰고 관찰은 코드가 가져온 값입니다.
ReAct는 이 세 걸음을 한 바퀴씩 되풀이합니다. 주황은 모델이 쓰고 초록은 코드가 가져온 것입니다.
논문 원본 그림 보기
다른 SDK와 tool runner
OpenAI의 Chat Completions API로 같은 루프를 짜면 뼈대는 같고 이름만 달라집니다. 이 글의 루프에서 바뀌는 곳은 표와 코드로 접어 두었습니다.
OpenAI로 짠 같은 루프와 달라지는 곳 보기
| Anthropic | OpenAI Chat Completions | |
|---|---|---|
| 멈춘 이유 | stop_reason == "tool_use" | finish_reason == "tool_calls" |
| 도구 요청서 | content 안의 tool_use 블록 | message.tool_calls 목록 |
| 인자 | input (딕셔너리) | arguments (JSON 글자) |
| 결과 돌려주기 | user 카드 한 장에 tool_result 모음 | 요청서마다 role: "tool" 카드 한 장 |
| 오류 표시 | is_error: true | 전용 칸이 없어 내용 글에 적음 |
def run_agent(question, max_turns=8):
    messages = [{"role": "user", "content": question}]
    for turn in range(max_turns):
        res = client.chat.completions.create(
            model=MODEL, messages=messages, tools=tools)
        choice = res.choices[0]
        messages.append(choice.message)
        # 멈춘 이유: tool_calls 가 아니면 끝
        if choice.finish_reason != "tool_calls":
            return choice.message.content
        for call in choice.message.tool_calls:
            args = json.loads(call.function.arguments)  # 글자를 풀어야 함
            out = run_tool(call.function.name, args)
            messages.append({"role": "tool",
                             "tool_call_id": call.id, "content": out})
    return f"{max_turns}번 안에 끝내지 못했습니다."
코드는 openai 패키지 3.31 기준입니다. OpenAI의 최신 안내 문서는 Responses API 예시로 쓰여 있지만 위 코드는 Chat Completions로 짰습니다.
Anthropic SDK(Anthropic이 만든 Python 도구 모음)에는 이 루프를 대신 돌려 주는 tool runner(베타)가 있습니다. 반복 상한도 옵션으로 둡니다. 문서는 사람 승인이나 로깅이 필요하면 직접 짠 루프를 쓰라고 안내합니다. 이 글처럼 직접 짜 본 루프가 있어야 runner가 대신하는 일을 알 수 있습니다.
루프에 꼭 넣을 네 가지
바퀴 수 한도, stop_reason 갈림길, 오류를 결과로 돌려주기, 응답을 그대로 기록하기. 이 네 가지가 직접 짠 Agent 루프의 뼈대입니다.
다음 글에서는 Agent 개발 프레임워크인 LangChain의 init_chat_model로 모델을 갈아 끼우는 법을 알아보겠습니다.
참고 자료
출처 8개 펼치기
- Handle tool calls, Anthropic: tool_use·tool_result 모양, tool_result 배치 규칙, is_error와 오류 문장 작성 안내
- Handling stop reasons, Anthropic: stop_reason 값별 의미와 처리
- Parallel tool use, Anthropic: 한 응답에 tool_use가 여러 개일 때 결과를 한 user 메시지에 담는 규칙
- Tool runner, Anthropic: 루프를 대신 돌려 주는 베타 기능과 반복 상한
- Building effective agents, Anthropic: Agent를 환경의 피드백을 받아 루프 안에서 도구를 쓰는 LLM으로 설명하고 최대 반복 횟수 같은 종료 조건을 권고
- ReAct: Synergizing Reasoning and Acting in Language Models, Yao 등 (2022): Thought·Action·Observation 형식, 그림, 반복 실패 한계
- Chat Completions API reference, OpenAI: finish_reason, role tool, tool_call_id, arguments 검증 주의
- anthropic (Python SDK) 1.15.0, openai 3.31.0, PyPI